跳到正文
模型
模型 Letta Research / FrontierMemory GPTClaudeGeminiLlama / MuseGrokKimiGLM

Letta:FrontierMemory 1.0 用下游任务测 Agent「会不会学」

Letta 10 月 21 日发布 FrontierMemory 1.0:不考生日爱好回忆,而考从历史轨迹生成记忆后能否提升编码/知识工作下游分。Opus 5.5 与 GLM-5.3 并列 73.3%,Kimi K3 66.7%,GPT-6.1 Sol / Gemini 4 Argon 60%,Muse Wonder 46.7%,Grok 4.7 33.3%。

官方称现有记忆榜(LoCoMo、LongMemEval)偏「回忆事实」,已被带 bash 搜文件的 harness 刷高,测不到「经验后是否变强」。FrontierMemory 把 DeepSWE、SkillsBench、AutomationBench 等改编成依赖任务/用户/环境记忆的 15 道题:Agent 先读含成败标注的轨迹(含无关任务),限 6 小时做梦式写记忆,再接入 Letta Code 等 harness 跑下游;榜分取 Opus 5.5 与 GPT-6 Sol 在 max 推理档的更高通关率。

记忆生成侧用 Letta Dream 测七款模型:Opus 5.5 与 GLM-5.3 并列 73.3%(任务成本约 $2.80 / $3.58),Kimi K3 66.7%,GPT-6.1 Sol 与 Gemini 4 Argon 60%(Sol 最便宜约 $0.77),Muse Wonder 46.7%,Grok 4.7 33.3%。Harness 对比里 Letta Dream 高于 OpenAI Agents SDK、Claude Managed Agents、Prime / Hermes 等;定性发现「可执行指令式记忆」优于空泛摘要,过拟合到具体文件大小的规则会失效。语料见 Hugging Face letta-ai/frontier-memory-corpus。
FrontierMemory 官方社交卡片:Benchmarking continual learning through memory

来源与参考资料

同栏目 · 模型

Base Labs / Baseten

Base Labs 开源 mammoth-1 / elephant-1:登顶决策模型榜

Baseten 旗下 Base Labs 10 月 21 日放出基于 Qwen3.5 后训练的决策模型:27B 的 mammoth-1 在 Jev Decision Index 0.4 以 71.24 位列 208 款第一;9B 的 elephant-1 为同榜最佳小模型,并与 Liquid d1-ultra 并列 Artificial Analysis Decision Index 第一。权重开源,Baseten API 免费试用一周。

Baseten / Base Labs 官方配图:mammoth-1 与 elephant-1 决策模型
Mirendil

Mirendil-Base:一名研究者用 Agent 3.5 个月、不到千万美元训出编码底座

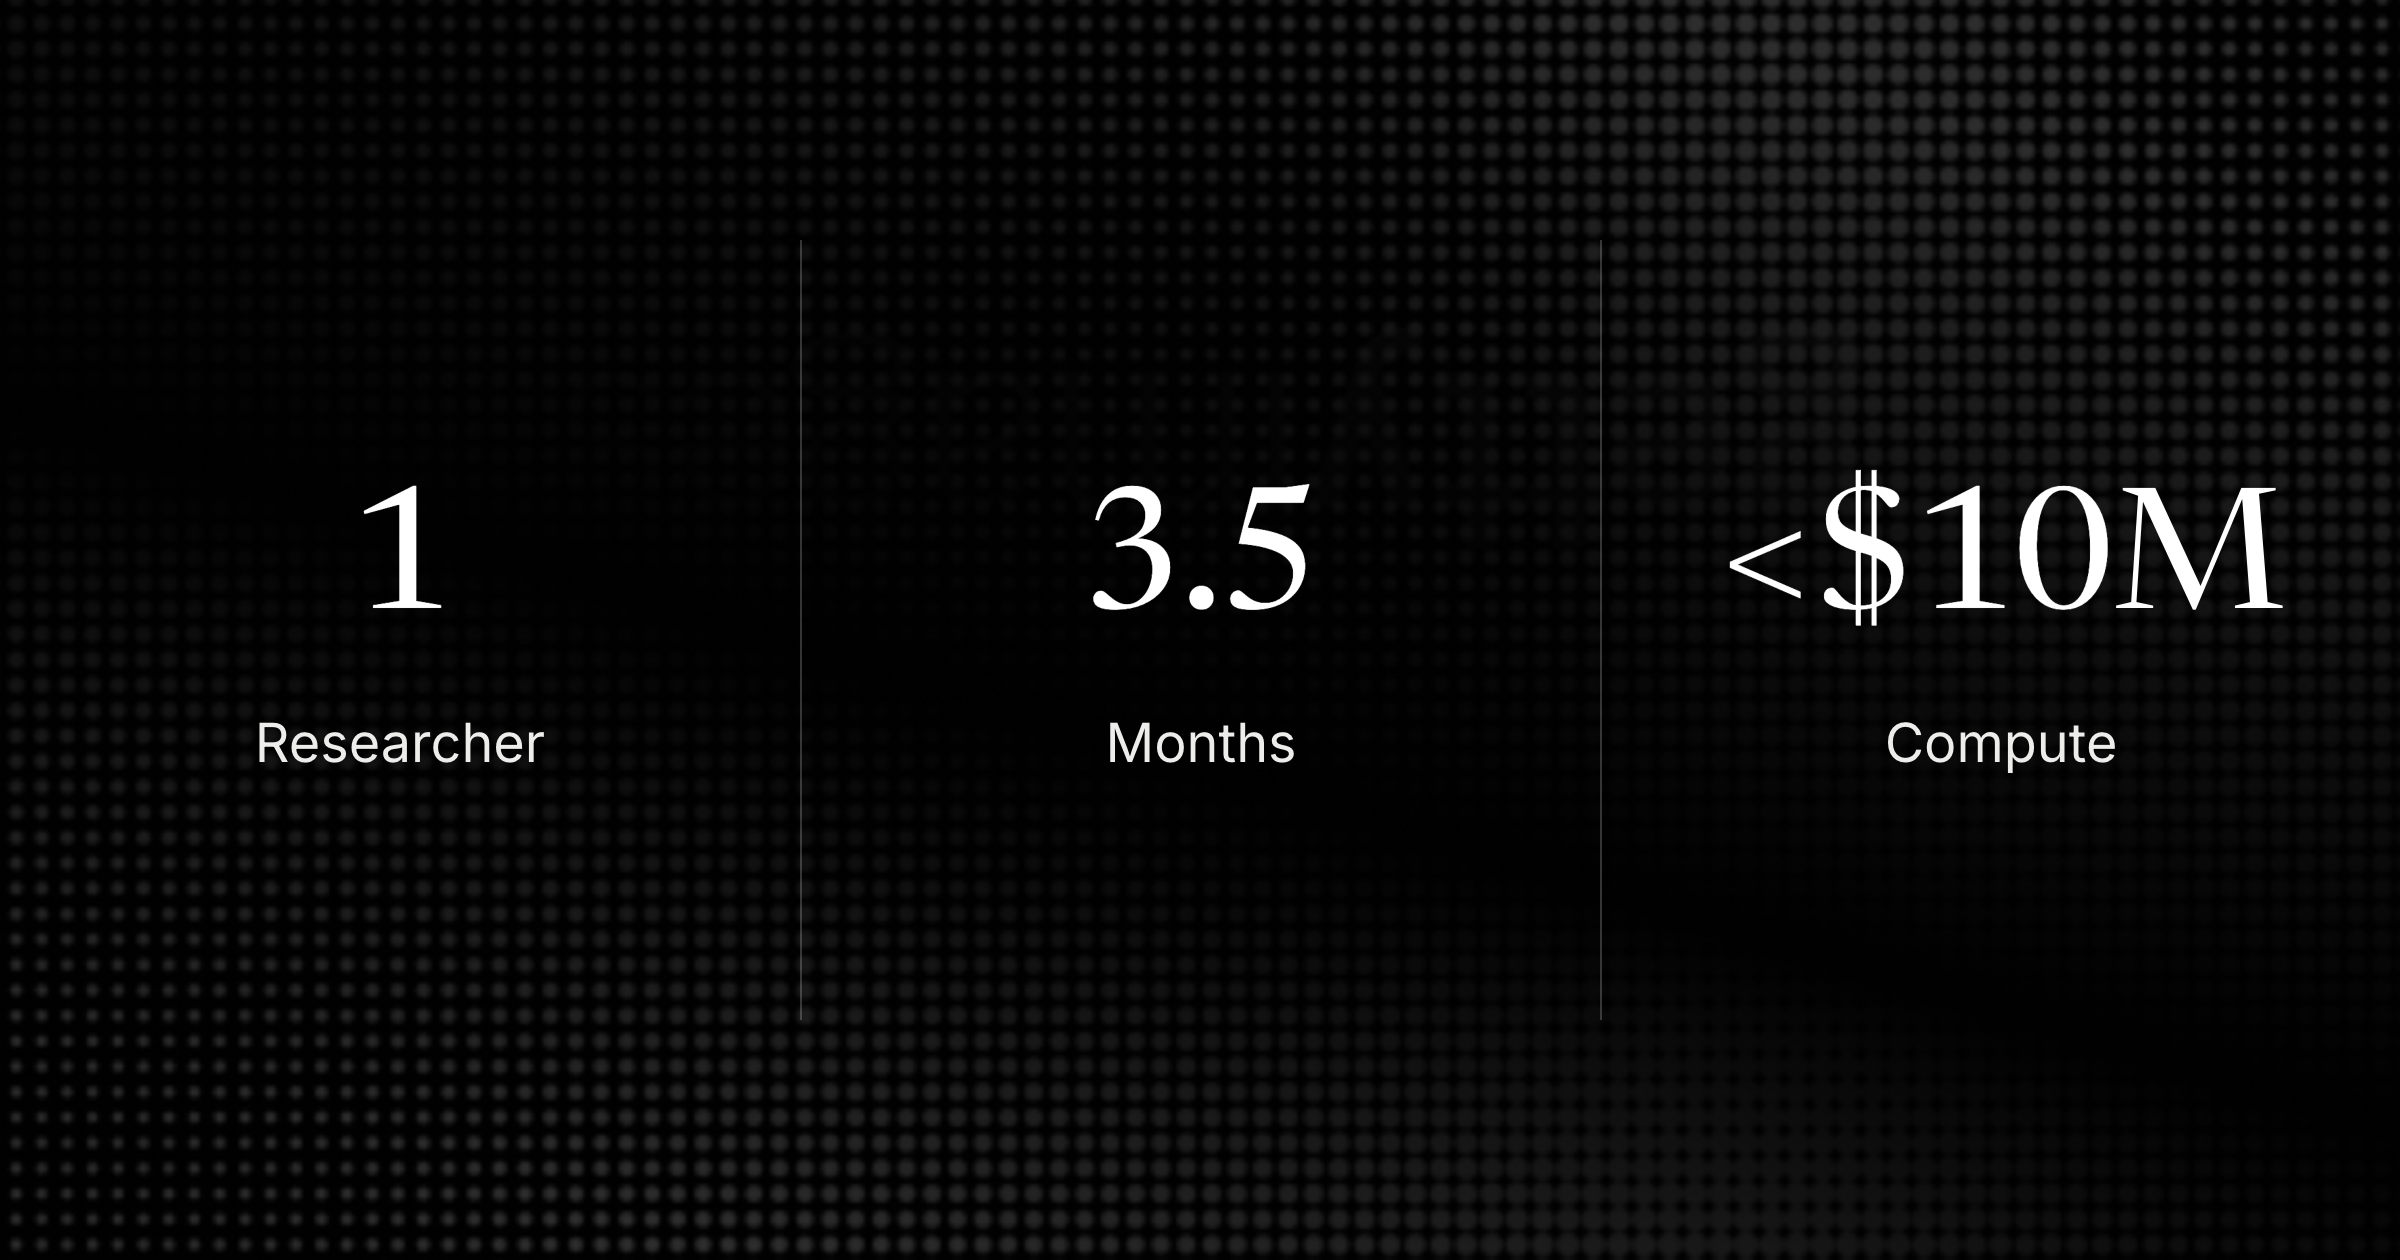
Mirendil 10 月 21 日公布 Mirendil-Base:单人研究者在 Agent 辅助下 3.5 个月、算力不足 1000 万美元完成预训练;代码逾 99% 由 Agent 编写,仅用公开数据、无蒸馏。厂商称在自建代码留出评测上优于多款开源编码底座。

Mirendil 官方配图:Pretraining at scale without a pretraining team
Recursive

Recursive 开源 Flint:单机可跑的 40B MoE 编码模型

Recursive Superintelligence 10 月 21 日发布 Flint:约 40B 总参、每 token 激活约 2.5B 的 MoE,面向本地 Agent 编码;厂商称在 <50B MoE 档领先 SWE-Bench Pro v2 / Terminal-Bench 2.1 等,优化推理在 M4 Pro 上逾 125 tok/s。Apache 2.0,Hugging Face / Ollama 可用。

Recursive 官方配图:Introducing Flint 本地编码模型