跳到正文
模型
模型 Mirendil DeepSeekKimiGLM

Mirendil-Base:一名研究者用 Agent 3.5 个月、不到千万美元训出编码底座

Mirendil 10 月 21 日公布 Mirendil-Base:单人研究者在 Agent 辅助下 3.5 个月、算力不足 1000 万美元完成预训练;代码逾 99% 由 Agent 编写,仅用公开数据、无蒸馏。厂商称在自建代码留出评测上优于多款开源编码底座。

实验刻意从空仓库起步:训练基建、架构、算法与数据管线均基于 PyTorch/JAX 等通用库自写;数据只来自 GitHub 与其他公开网页/数据集,未采购额外语料、也未用蒸馏或合成数据。总算力含小规模实验、最终训练跑、Agent token 与数据处理。官方称目标是验证「前沿编码底座是否还能只靠大团队」。

公开对比用 bits-per-byte 衡量对留出代码与七个训后公开仓库的预测:Mirendil-Base 在自建图上优于 Nemotron-550B-Base、GLM-5.3、DeepSeek-V4-Pro-Base、Inkling 等(Kimi-K3 仍更低损失);外部七仓平均 0.222,介于 Kimi-K3(0.193)与其余开源档之间。更大的 Base-Large / Base-XL 仍在训(约 80% / 19%);已开始后训练,API 与独立评测后续放出。分数为厂商 harness。
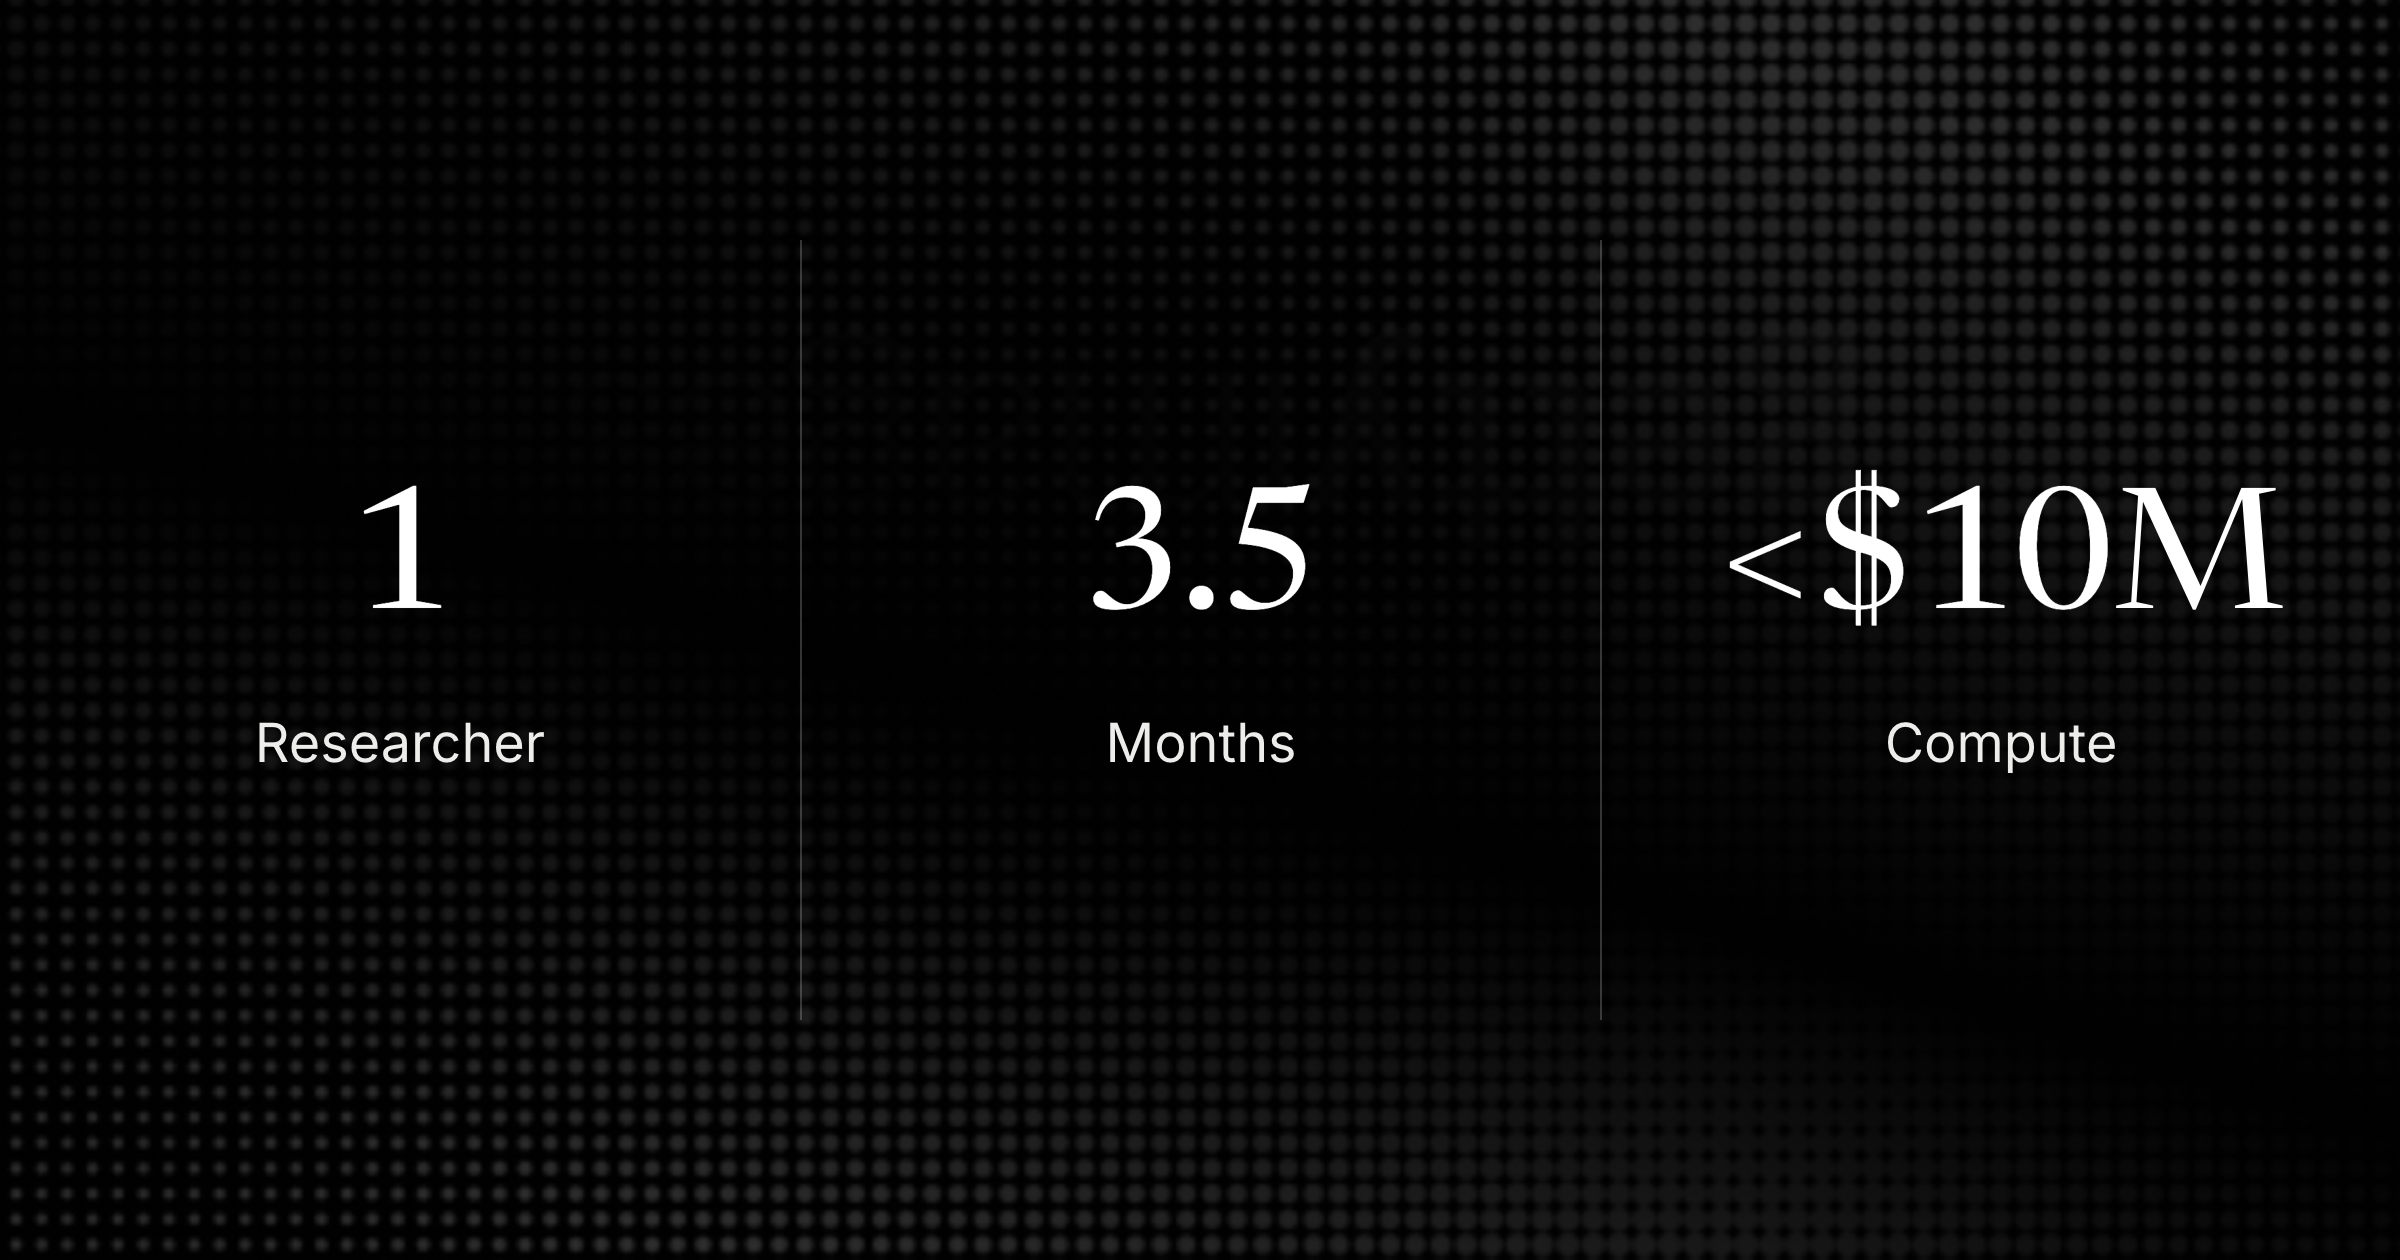
Mirendil 官方配图:Pretraining at scale without a pretraining team

来源与参考资料

同栏目 · 模型

Base Labs / Baseten

Base Labs 开源 mammoth-1 / elephant-1:登顶决策模型榜

Baseten 旗下 Base Labs 10 月 21 日放出基于 Qwen3.5 后训练的决策模型:27B 的 mammoth-1 在 Jev Decision Index 0.4 以 71.24 位列 208 款第一;9B 的 elephant-1 为同榜最佳小模型,并与 Liquid d1-ultra 并列 Artificial Analysis Decision Index 第一。权重开源,Baseten API 免费试用一周。

Baseten / Base Labs 官方配图:mammoth-1 与 elephant-1 决策模型
Recursive

Recursive 开源 Flint:单机可跑的 40B MoE 编码模型

Recursive Superintelligence 10 月 21 日发布 Flint:约 40B 总参、每 token 激活约 2.5B 的 MoE,面向本地 Agent 编码;厂商称在 <50B MoE 档领先 SWE-Bench Pro v2 / Terminal-Bench 2.1 等,优化推理在 M4 Pro 上逾 125 tok/s。Apache 2.0,Hugging Face / Ollama 可用。

Recursive 官方配图:Introducing Flint 本地编码模型
Anthropic

Anthropic:Claude 从头设计蝎神经毒素迷你蛋白结合体

内部研究模型设计并经实验测试 211 个候选,17 个达到结合标准;最强 Cn2-B1 达个位数纳摩尔亲和力,序列与数据已公开至 Hugging Face,尚未做细胞中和或动物药效。

Anthropic 研究页配图:Claude 设计蝎神经毒素蛋白结合体