跳到正文
芯片
芯片 Cerebras Kimi

Cerebras:把约 3T 的 Kimi K3 铺到 59 片晶圆,自称千级 tok/s

Cerebras 10 月 22 日技术博文以开源 Kimi K3(约 3T 参)为例,讲解如何在多片 WSE-3T 上做万亿级推理:4bit 权重、8bit KV、约 256k 请求假设下需 59 片晶圆;权重常驻片上 SRAM,层间只传激活,自称可达 1000–2000+ tokens/s。

官方博文《How we deploy Trillion-parameter frontier models on Cerebras》写明:单片 WSE-3T 片上内存约 44GB,万亿级模型权重本身就要 TB 级,因此要把模型按层铺到多片晶圆的流水线。示例模型是开源 Kimi K3(约 3T 参、69 层线性注意力 + 24 层稠密);文中引用其 Terminal-Bench 2.1 约 88.3%、BrowseComp 约 91.2% 等厂商对照数字。

配置假设:平均请求约 256k、权重 4bit(对齐 HF 实现)、KV cache 8bit。估算每层约 16GB;稠密层每片只放一层(余量留给 KV),线性注意力层可两层共片。于是 69 线性层要 35 片、24 稠密层要 24 片,合计 59 片。层间经以太网 RDMA 传激活,自称约 2 微秒/跳;权重尽量不挪片。流水线各阶段可同时处理不同请求,并发上限由稠密层晶圆上剩余 KV 空间决定。文中数字为厂商示意配置,非独立第三方实测。
Cerebras 官方配图:How we deploy trillion-parameter frontier models

来源与参考资料

同栏目 · 芯片

NVIDIA Newsroom

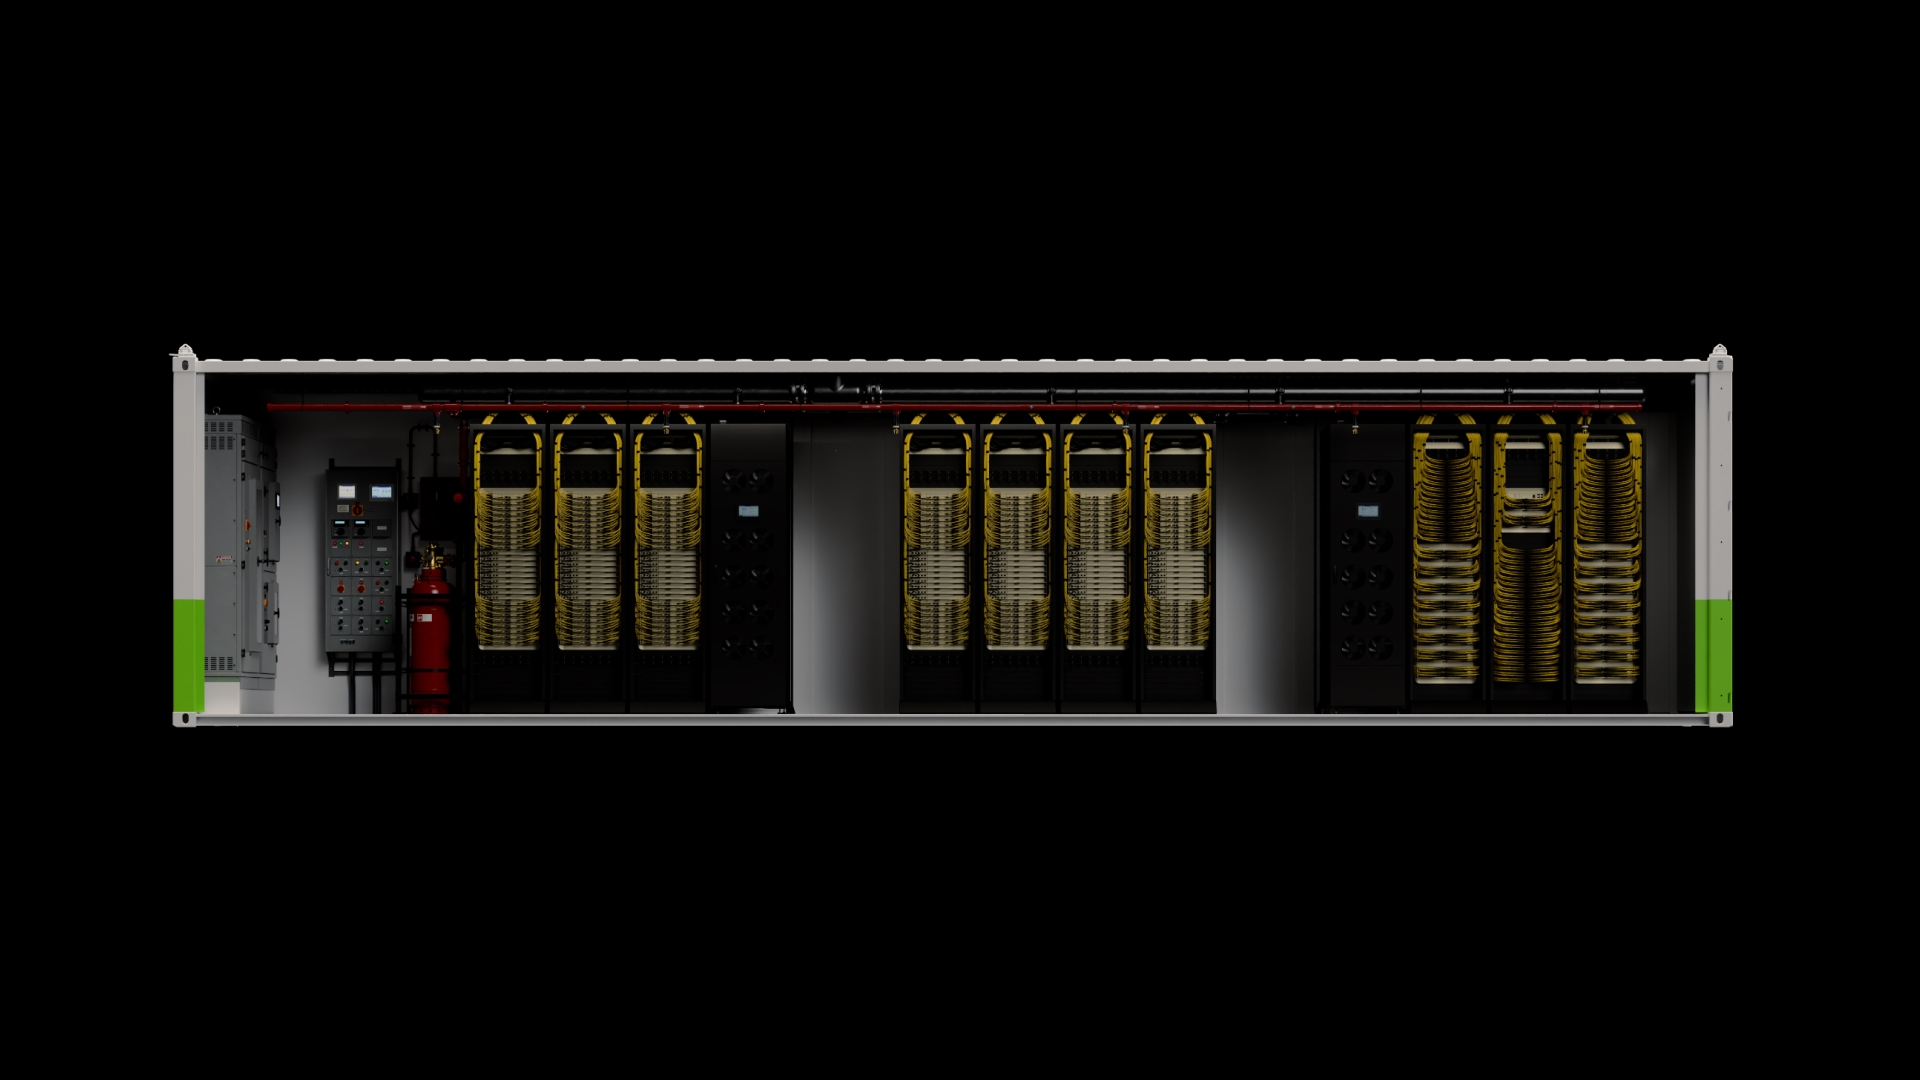
NVIDIA 发布 DSX POD:集装箱式 Vera Rubin AI 工厂参考设计

GTC Berlin 上推出 DSX POD,由合作伙伴在模块化集装箱内集成验证完整 Vera Rubin 工厂,宣称预备场地部署可从约 6 个月缩短至最快 14 天,全球交付目标 2027 年初。

NVIDIA DSX POD 模块化 AI 工厂参考设计官方配图
NVIDIA Blog

Google Cloud A5X:Vera Rubin NVL72 机柜下月全面可用

NVIDIA 与 Google Cloud 10 月 21 日宣布:搭载 Vera Rubin NVL72 的 A5X 实例下月 GA,并规划扩至欧洲;公司称 Rubin 基础设施可扩到最多约 96 万颗 Rubin GPU,首批客户含 David Silver 的 Ineffable Intelligence。

NVIDIA 官方配图:Google Cloud × Vera Rubin 基础设施
Google Developers Blog

Google:vLLM / SGLang 原生 PyTorch 上 TPU,Qwen·DeepSeek·Kimi 等可跑

Google 开发者博客 10 月 20 日宣布基于 TorchTPU 的 vLLM-TorchTPU 与 SGLang-TorchTPU:用熟悉的 PyTorch 栈在 TPU 上做生产推理;已公开 SemiAnalysis InferenceX/AgentX 成绩,并称支持 Qwen、DeepSeek、GLM、Kimi、Gemma4 等主流开源族。

Google 官方配图:Announcing New vLLM and SGLang Inference Engines on TPU