Google:vLLM / SGLang 原生 PyTorch 上 TPU,Qwen·DeepSeek·Kimi 等可跑
Google 开发者博客 10 月 20 日宣布基于 TorchTPU 的 vLLM-TorchTPU 与 SGLang-TorchTPU:用熟悉的 PyTorch 栈在 TPU 上做生产推理;已公开 SemiAnalysis InferenceX/AgentX 成绩,并称支持 Qwen、DeepSeek、GLM、Kimi、Gemma4 等主流开源族。
此前 vLLM/SGLang 在 TPU 上主要走 JAX 后端;本次与 Inferact、RadixArk 等合作,在 TorchTPU(把 TPU 当原生 PyTorch 设备)之上做了生产向引擎:自动前缀缓存、推测解码、上下文并行、Prefill/Decode 分离、多模态与超大模型并行等,KV 搬运走开源库 TPU Sync。官方称 SGLang-TorchTPU 已在 Meta 生产环境跑;vLLM 侧为 Kimi K3(约 2.8T)做了 Pallas megakernel,单用户 decode 自称逾 700 tok/s(Ironwood TPU)。
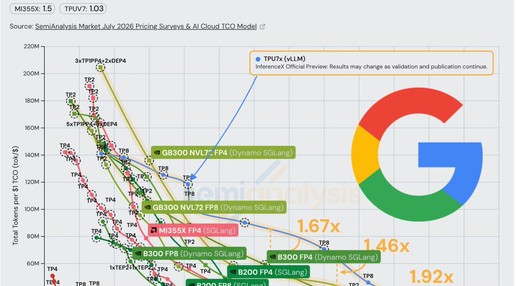
公开榜侧:在 SemiAnalysis InferenceX 上,Qwen 3.5 on Ironwood 进一步压到约 2.01 美分/百万 token 的整体最低成本区间,并在 AgentX 长上下文多智能体轨提交新成绩。仓库已开:vllm-torchtpu、sglang-torchtpu、torch_tpu;JAX 版继续维护。对开源权重党,这是「同一套 vLLM/SGLang 习惯」迁到谷歌硅的一条正路。