整理:TopAIMap 编辑
SemiAnalysis:Google 首交 TPUv7 FP8 + vLLM 智能体推理成绩,性价比达 GB300 NVL72 FP4 的 1.67 倍;4 芯片即可压过多数帕累托前沿
10 月 14 日晚间(约 7:36pm PT;帖文时间 2026-10-15 02:36 UTC),SemiAnalysis 公布 Agentic Inference Benchmark(AgentX)首批 Google TPUv7 成绩:TorchTPU + vLLM 以 FP8 跑在 TPUv7 上,性能/美元比 NVIDIA GB300 NVL72 的 FP4 配置高出约 1.67 倍。续帖称仅 4 颗 TPUv7 芯片,在多数帕累托前沿上按 TCO 性能压过 GB300 NVL72 FP4;低交互场景下 GB300 FP4 仍占优,但同场景 TPUv7 FP8 仍优于 GB300 FP8。协作方包括 Google TPU、TorchTPU、Inferact、Red Hat 与 vLLM 团队;全文长文称稍后发布。
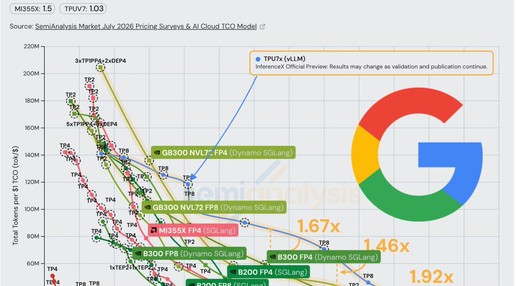
基准含义:SemiAnalysis 强调 AgentX 面向智能体负载的四类特征(多轮会话可达数十到上百轮、长上下文含系统提示与工具定义、工具调用与状态累积等),不同于短问答聊天。此次是 Google 首次把 TPUv7 FP8 + vLLM 外部化提交到该榜,被解读为「TPU 软件栈向外开放、对标英伟达高端推理机架」的信号。数字口径是 perf per dollar / TCO,不是单卡 raw token/s;图表对比轴含交互性(interactivity)区间。
真实用法:云上与自建推理团队若跑多轮 agent(带工具、长 session),可把「4×TPUv7 FP8 + vLLM」当作相对 GB300 NVL72 FP4 的成本对照——在多数工作点更省钱,但低交互、偏吞吐的点仍可能选 GB300 FP4。落地依赖 Google 的 TorchTPU/vLLM 路径与云上 TPU 配额,而非消费级显卡;Inferact、Red Hat 出现在致谢里,说明企业 Linux/推理发行版侧也在跟。尚未见面向个人笔记本的一键安装包。
谁能用:成绩来自 SemiAnalysis 公开帖与图表,报告全文待发;评测栈面向云/机架推理,不是 Chat App。Google Cloud TPU(含 v7 代际,以 GCP 实际开放区域与配额为准)对企业与研究客户按用量计费;无 Free/Pro 消费套餐,也无 ChatGPT 式 App/Search 入口。vLLM、TorchTPU 开源组件可自建,但仍需拿到 TPU 硬件或云实例。NVIDIA GB300 NVL72 对照侧同属数据中心产品。本新闻不改变 Claude/GPT 等模型的 C 端售价。
解读:1.67× 写的是「每美元智能体推理」,打的是英伟达旗舰机架的性价比叙事,而不是「TPU 绝对更快」。Google 愿意把 vLLM+FP8 成绩外送,说明想拉第三方软件生态,减少「只会跑自家模型」的刻板印象。讨论:1. 智能体负载的瓶颈更在多轮长上下文,还是单步 decode 速度?2. 若 4 芯片就能在 TCO 上压过 NVL72,云厂商会不会加速把 agent 默认路由到 TPU?
参考资料