整理:TopAIMap 编辑
NVIDIA 开放 Nemotron 3.5 Bolt 74B-A9B 权重:2 比特压进 24GB、RTX Spark 上 84 token/秒,AA 智能指数 21.4 居 100B 以下美国模型第一
10 月 15 日,NVIDIA 在 Hugging Face 开放 Nemotron 3.5 Bolt 74B-A9B 24GB 权重。它由 Nemotron 3.5 Super VL(120B-A12B)压缩而来,总参 740 亿、激活 90 亿,专家层量化到约 2 比特,整个模型只占 24GB,面向在 RTX/DGX Spark 等本地设备上常驻跑智能体。Artificial Analysis 给出智能指数 21.4,在 100B 参数以下模型中排第 4、美国模型中第一。
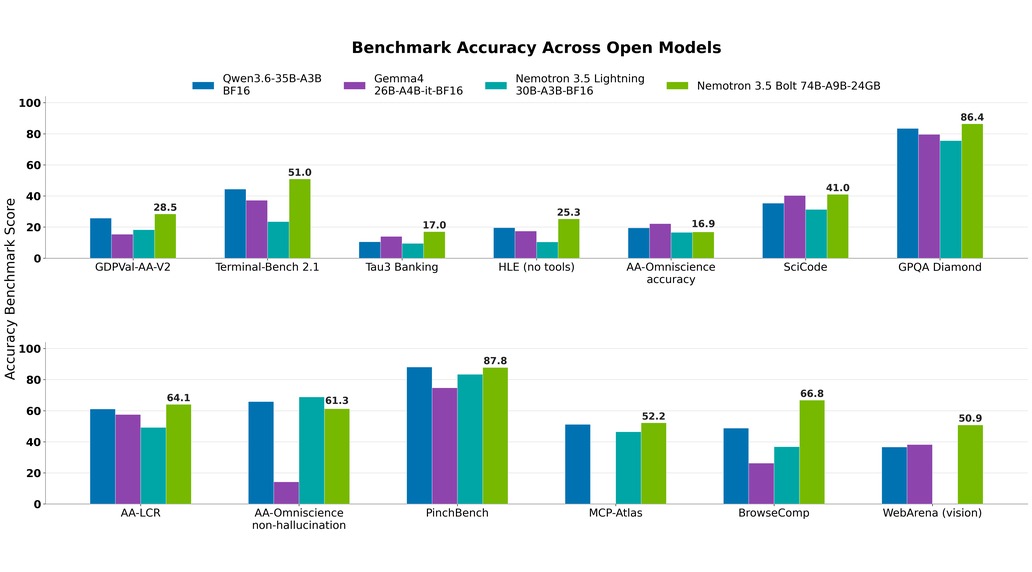
技术要点:用 NVIDIA 自研 Star Elastic 做结构化压缩(专家 top-K 从 22 降到 9),再对专家层做 IQ2_XXS(每参数 2.0625 比特)量化感知蒸馏;支持文本、图片、视频输入,上下文最长 256K。配套 1.13B 的 LiLiCorr 推测解码草稿模型,在 RTX Spark(Surface Laptop Ultra,128GB)上用 llama.cpp 测得 84 token/秒。官方自测:Terminal-Bench 2.1 51.0、GPQA Diamond 86.4、BrowseComp 66.8、WebArena 50.9,均高于 Qwen3.6-35B-A3B 和 Gemma 4 26B-A4B;但实测速度略慢于两者(84 vs 97/101 token/秒),AA 也指出它每道题平均输出 8.2 万 token,是 Super VL 的 1.8 倍。
谁能用:免费开放权重,许可证 OpenMDW-1.1,可商用;Hugging Face 上无需申请即可下载,提供 24GB 主模型、GGUF 版、LiLiCorr 草稿模型和未量化的 BF16 版(便于再训练)。本地可用 llama.cpp(RTX Spark)或 vLLM(DGX Spark、A100/H100/Blackwell)跑,官方测试硬件还包括 RTX 5090;LM Studio 社区和 Unsloth 已上架 GGUF。官方未公布托管 API 或付费档。
真实用法:NVIDIA 把它定位为「跟其他应用一起常驻」的本地智能体底座,主打调用工具、浏览网页、操作终端;官方称在 PinchBench 排第 1,在 WebArena、BrowseComp 排第 2(对比内存占用相近的模型)。目前公开的使用主要是社区量化和本地部署测速,还没看到成规模的产品案例。
解读:Bolt 押的是一个反直觉的结论——在 24GB 的预算里,把大模型压到 2 比特,比从头训一个小模型再量化到 4 比特更聪明。这条路线如果成立,RTX/DGX Spark 这类「AI PC」就有了能用的本地智能体模型,也给 NVIDIA 卖本地硬件添了筹码。代价是更慢、更啰嗦。讨论:1. 本地智能体更看重「聪明但慢一点」还是「快但笨一点」?2. 「大模型极限压缩」会不会取代小模型从头训练,成为端侧模型的主流做法?