跳到正文
芯片
芯片 Google Quantum AI / X @sundarpichai GPTGemini

整理:TopAIMap 编辑

谷歌 Willow 芯片首次在真机实现「魔法态培育」:错误降约 40 倍,逻辑保真度 99.99%,成果登上 Science

10 月 15 日(PT)下午,谷歌 Quantum AI 与 CEO Sundar Pichai 官宣:团队在 105 量子比特的 Willow 处理器上首次在真实硬件跑通「魔法态培育」(magic state cultivation),相对未培育方法错误约降 40 倍,T 态逻辑保真度达 99.99%,论文同日发表于 Science。Pichai 原帖约 31 万浏览、5750 赞;@unusual_whales 转发热度约 50 万浏览。这是量子纠错里卡了约 20 年的资源瓶颈之一——有估算称整机容量最高约 95% 可能被用来造魔法态,几乎没剩给真正计算。
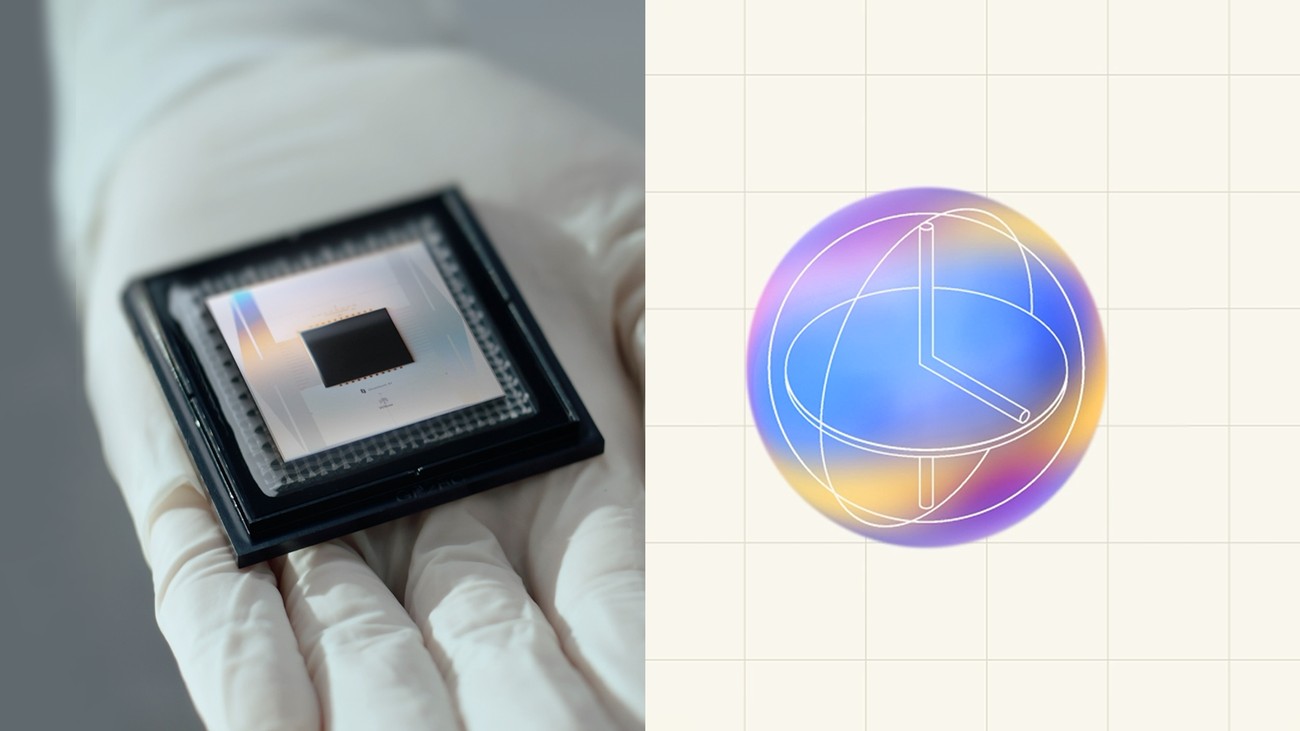
谷歌官方配图:Willow 处理器上魔法态培育示意,Science 发表,相对未培育错误约降 40 倍、逻辑保真度 99.99%

技术上,魔法态是做「通用」量子计算(超越经典可模拟的那一类操作)所需的一次性资源:用掉就不能复用,还特别难造干净。2024 年谷歌内部把文献里的想法收成「培育」方案——把带噪态注入芯片上一小块区域,再做一系列协同测量当过滤器,筛掉坏尝试,同时把纯态编码放大到可用规模。此次是首次在物理硬件上证明这一套能工作:相对未培育 T 态,错误约降 40 倍,过滤后约保留 8% 的尝试,逻辑保真度 ≥0.9999(即 99.99%)。官方博客强调这是「实用解」的第一次硬件演示,而不是纸上模拟。

要打折的地方:这是实验室硬件上的纠错资源突破,不是面向开发者的可租用量子云新品,也没有公开「谁都能提交作业」的 API 档位;距离大规模容错商用仍有完整堆栈要补(更多逻辑量子比特、编译、算法与成本)。加密圈有人把「比特币安全」一并炒热,但谷歌原文谈的是纠错资源瓶颈,并不等于短期就能破解现有公钥体系。数字来自谷歌自述与 Science 论文,社区独立复现要等硬件与方法细节进一步公开。

谁能用:普通用户和 App/Pro/Ultra 订阅者现在都用不了这块能力——它跑在谷歌 Quantum AI 的 Willow 研究机上,不是 ChatGPT/Gemini/Antigravity 之类的产品面。可读内容:Science 论文 + Google 官方博客(goo.gle / blog.google 量子专栏)免费公开;没有商业 API、没有托管推理、没有等候名单。企业若已接入谷歌云量子相关实验通道,仍以现有研究配额为准,本次发布本身不附带新的公开计价档。

解读:大模型这边卷的是参数和 agent,量子这边卡的是「造干净魔法态太贵」——同一天两边都在抢头条,但性质完全不同:Willow 这条是硬件纠错供给侧的结构性进展,短期不改变谁能用上 Gemini,却会改写容错量子机要做多大才划算的账本。讨论:1. 魔法态成本掉一个数量级后,最先被「算得起」的应用会是材料/化学,还是密码学焦虑会先被市场定价?2. 开源大模型一天一个,量子硬件突破却高度集中在少数实验室——这对「AI+科学」叙事意味着什么?原帖:https://x.com/sundarpichai/status/2110804295352488143 ;Quantum AI:https://x.com/GoogleQuantumAI/status/2110799626554998921 ;博客:https://blog.google/innovation-and-ai/models-and-research/quantum-computing/magic-state-cultivation-quantum-computing/
同栏目 · 芯片

台积电官方新闻稿 / 财报电话会 / TrendForce / X

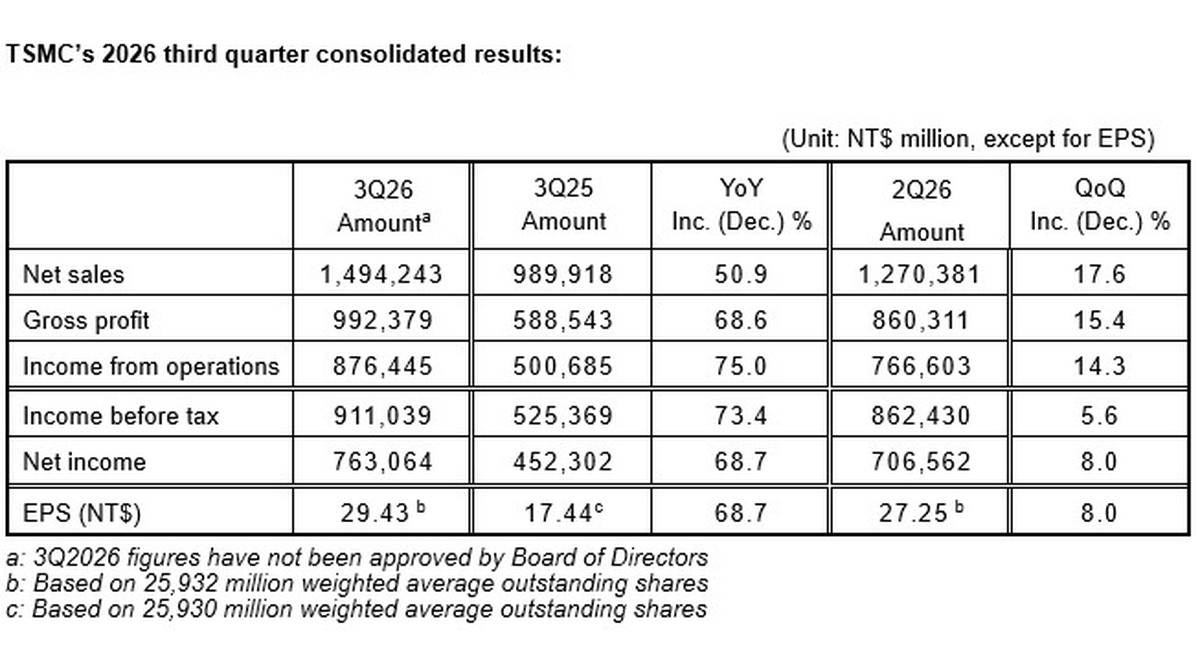
台积电 Q3 营收 467.2 亿美元同比增 41%,2nm 已占 8%;Q4 指引最高 543 亿,确认与 Terafab 洽谈

10 月 15 日,台积电公布 2026 年第三季度财报:营收 467.2 亿美元,同比增 41.2%、环比增 16.2%,毛利率 66.4%;2nm 首次占晶圆营收 8%。Q4 营收指引 523–543 亿美元,全年增速上调至约 44%;魏哲家确认正与马斯克的 Terafab 洽谈,但坚持晶圆厂须由台积电运营。

TSMC 3Q26 consolidated results table
SemiAnalysis

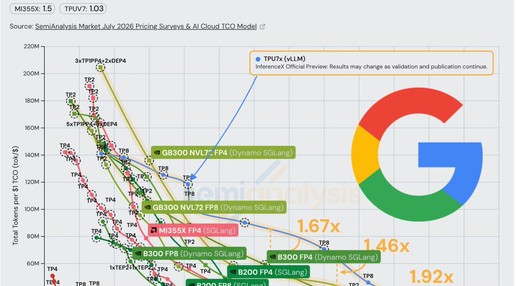
SemiAnalysis:Google 首交 TPUv7 FP8 + vLLM 智能体推理成绩,性价比达 GB300 NVL72 FP4 的 1.67 倍;4 芯片即可压过多数帕累托前沿

10 月 14 日晚间(约 7:36pm PT;帖文时间 2026-10-15 02:36 UTC),SemiAnalysis 公布 Agentic Inference Benchmark(AgentX)首批 Google TPUv7 成绩:TorchTPU + vLLM 以 FP8 跑在 TPUv7 上,性能/美元比 NVIDIA GB300 NVL72 的 FP4 配置高出约 1.67 倍。续帖称仅 4 颗 TPUv7 芯片,在多数帕累托前沿上按 TCO 性能压过 GB300 NVL72 FP4;低交互场景下 GB300 FP4 仍占优,但同场景 TPUv7 FP8 仍优于 GB300 FP8。协作方包括 Google TPU、TorchTPU、Inferact、Red Hat 与 vLLM 团队;全文长文称稍后发布。

SemiAnalysis Agentic Inference 图表:Google TPUv7 FP8 vLLM 与 GB300 NVL72 性价比对比
Artificial Analysis / X @ArtificialAnlys

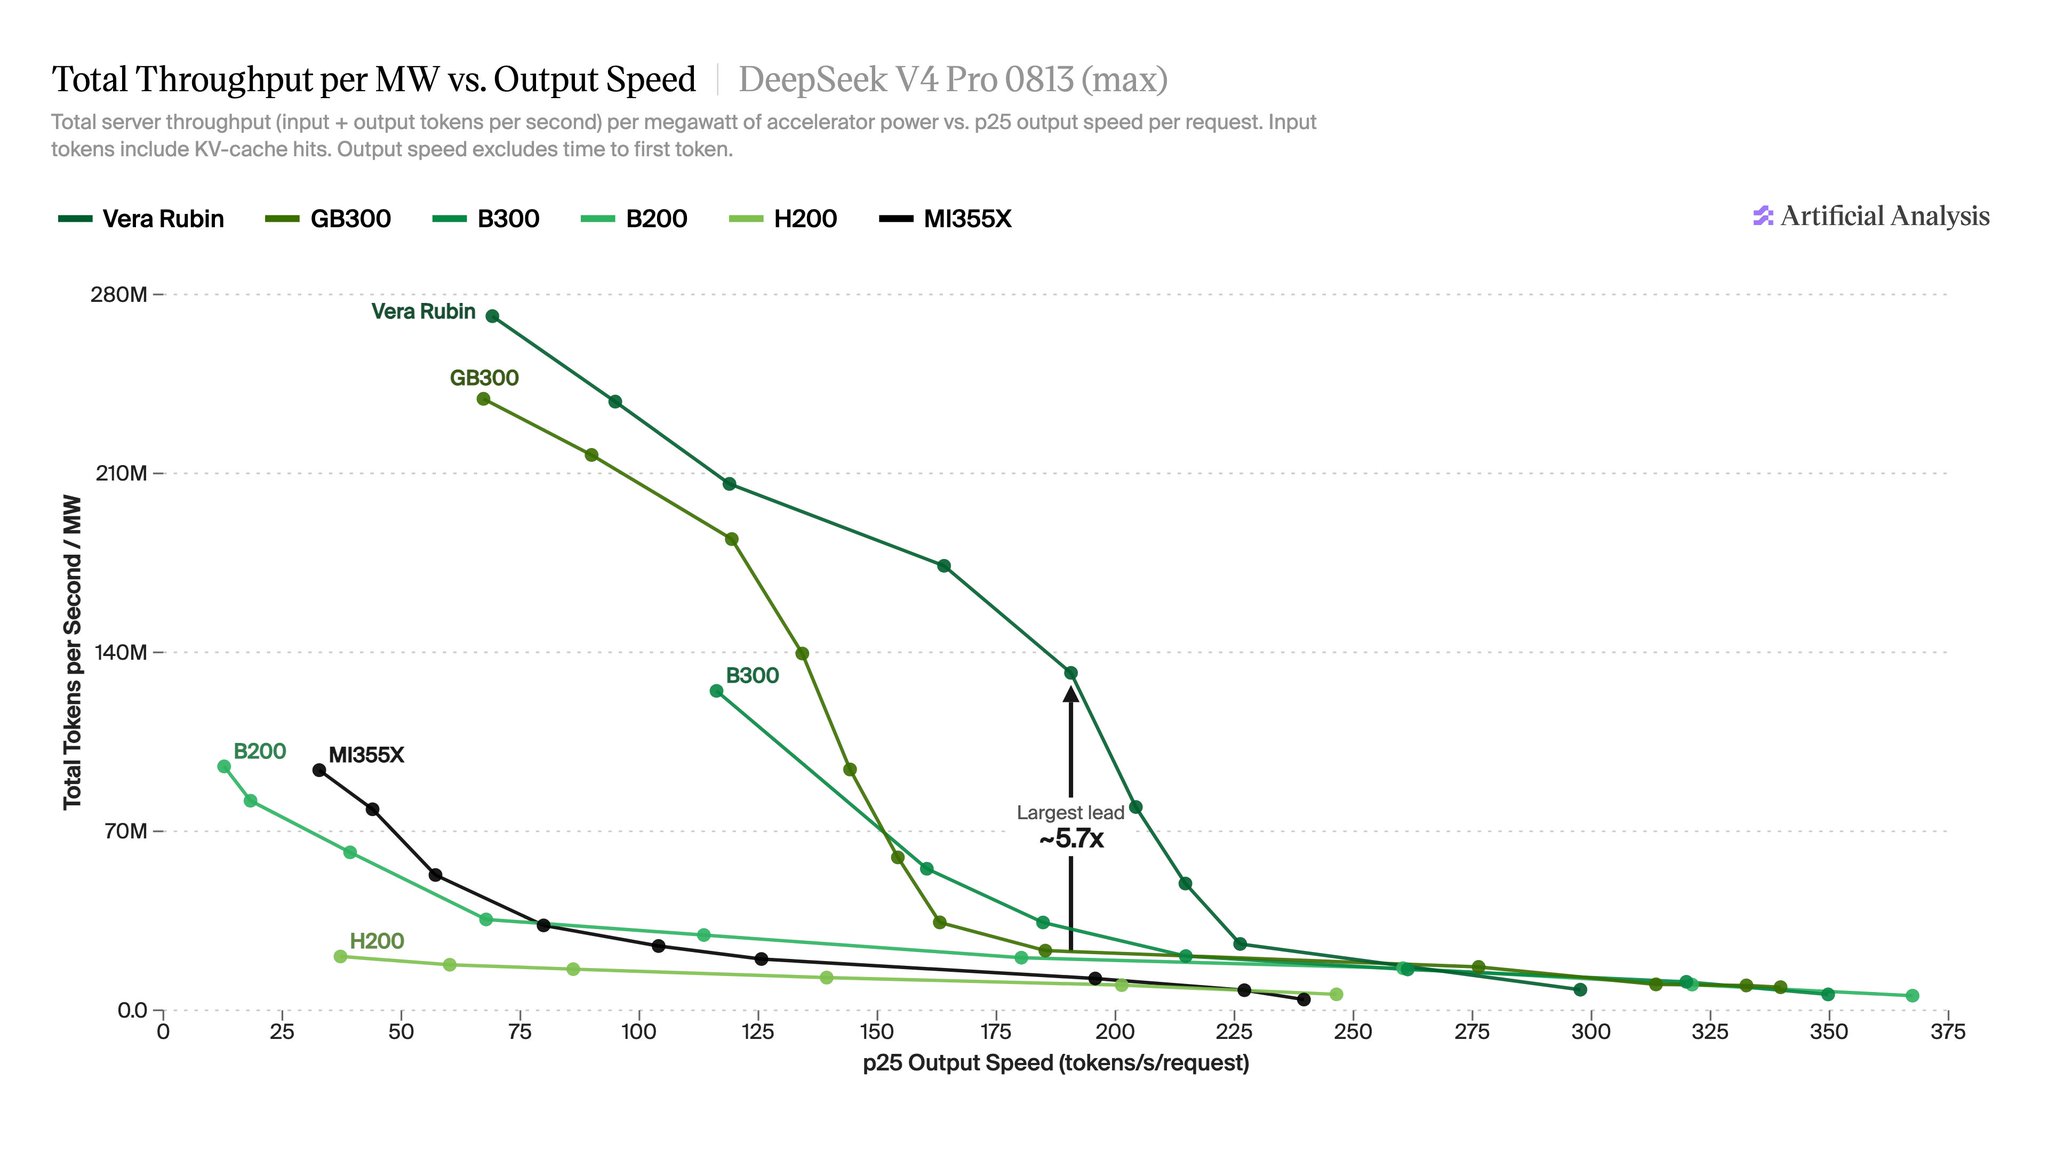
Vera Rubin 首份第三方智能体推理成绩:每兆瓦吞吐最高达 GB300 的 5.7 倍,DeepSeek V4.1 Flash 跑到 906 tok/s

10 月 15 日约 6:18pm(PT),Artificial Analysis 公布 NVIDIA Vera Rubin NVL72(72 颗 Rubin GPU + 36 颗 Vera CPU 的机架级系统)在 AA-AgentPerf 智能体编程推理基准上的首批结果:在同等用户速度下,每兆瓦 GPU 功耗的总吞吐最高是上一代 GB300 NVL72 的约 5.7 倍(DeepSeek V4 Pro,约 190 tok/s/用户),DeepSeek V4.1 Flash 约 5.4 倍、GLM-5.2 约 3.0 倍、Kimi K3 约 2.8 倍;DeepSeek V4.1 Flash 单用户最高 906 tok/s,是该榜所有模型最快纪录。

Artificial Analysis 图表:DeepSeek V4 Pro 上 Vera Rubin、GB300、B300、B200、H200、MI355X 每兆瓦总吞吐与单用户输出速度对比,标注最大领先约 5.7 倍