整理:TopAIMap 编辑
PrismML 发布 Bonsai 2 三元权重小模型:2B/4B/9B(约 0.43/0.95/2.0GB),基于 Qwen3.5,面向手机与浏览器本地助手;Apache 2.0,家族已覆盖至 27B
10 月 15 日约 1:03pm(PT),PrismML 官方账号 @PrismML 宣布扩展 Bonsai 2 家族,新推基于 Qwen3.5 的三元(ternary)权重型号 2B、4B、9B:体积约 0.43GB / 0.95GB / 2.0GB,强调指令跟随、少循环、端侧工具调用与视觉理解。官方称 9B 在常见指令与日常数学任务上大约少用 40% token。官宣帖约 2.2 万浏览、677 赞;Hugging Face Transformers 维护者 @xenovacom 等演示浏览器 WebGPU 上 2B 可达数百 tok/s。
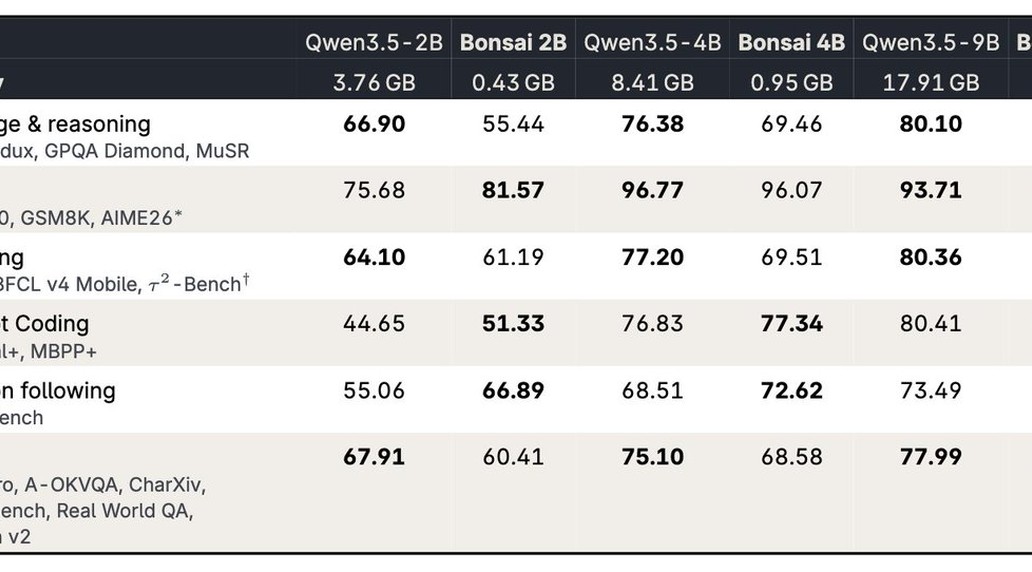
规格与条件:Bonsai 2 现为 2B–27B 四档,面向 PC/手机/可穿戴上的本地助手,而非冲 IMO 的前沿大模型。社区实测:RTX 5060 Ti 16GB 上 27B 三元量化相对普通 4-bit 可约 2× 解码、VRAM 近乎减半;iPhone 端有约 34–90 tok/s 的演示口径;浏览器 WebGPU 上 2B 有「数百 tok/s」演示。4B/9B 另附 MTP/DFlash2 等投机解码草稿模型,偏编码改写场景更明显。注意:三元权重通常需要 Prism 分叉的 llama.cpp / 专用内核,不是随便丢进原版 llama.cpp 就能跑。
真实用法:Locally AI 等 App 已日更接入做端侧聊天;Darkbloom 提供 9B 托管试用不限前 100 人约 2.5 亿免费 token;开发者拿 4B 在 Mac 上跑多路邮件摘要/JSON 抽取(有人报 32 并发、峰值内存 <4GB)。适合「高并发、低显存、要工具调用」的本地 agent,而不是替代 Opus/Gemini 做长程规划。
谁能用:权重 Apache 2.0,个人与商业都可免费下载使用(以模型卡与许可证为准);Hugging Face 上已有 `prism-ml/Ternary-Bonsai-2-2B-gguf` 等仓库及社区 GGUF/MLX。无官方闭源 API 订阅墙;第三方托管(如 Darkbloom)另计。手机/浏览器本地跑取决于设备内存与是否支持三元内核;27B 仍需中高端本地显存或统一内存。
解读:在 Muse Spark Open、Nemotron、Step 5 刷屏的「超大开源」日,PrismML 走反方向——把助手能力压进 0.5–2GB,赌端侧 agent 的量。三元路线的胜负手是生态内核能不能跟得上,而不只是榜分数。讨论:1. 本地小模型要先拼「工具调用稳定性」还是「裸推理分」?2. 若浏览器就能跑实用助手,云端小模型 API 的价格带还站得住吗?