跳到正文
模型
模型 LuminaBench / Microsoft EF Core GPT

微软 EF Core 评测配置露出 gpt-6.1-terra:OpenAI 疑备新 Terra 档

Microsoft 公共仓库 dotnet/efcore 已合并的评测配置把默认裁判模型写成 gpt-6.1-terra、任务模型写成 gpt-6.1-sol;LuminaBench 等据此认为 OpenAI 正准备新一代 Terra,但公开发布仍未确认。

LuminaBench 核对:PR #39217(约 10 月 16 日合并,提交 6f99389)在 eng/harness-evaluation 多份 eval.yaml 中更新模型默认值。工具向 tooling/eval.yaml 可见 defaults:model=gpt-6.1-sol、judge_model=gpt-6.1-terra,经 Copilot SDK 执行;裁判推理档默认 medium、超时 10 分钟。约 18 套评测配置出现该标识(多数自 GPT-5.6 Terra/Sol 换代)。

公开代码只证明微软团队把评测默认值指向这些模型 ID,不能证明定价、能力、上市日或对外部可用。官方模型列表尚未挂出 GPT-6.1 Terra;社区另有「比 Sol 更强更便宜、数日内发布」等未证实传言,应以代码事实与官方公告为准。
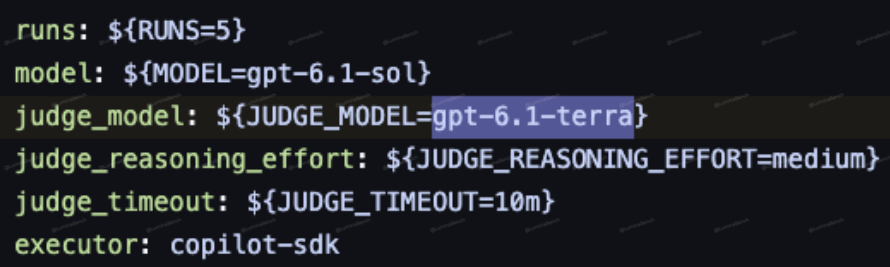
LuminaBench:Microsoft EF Core 评测配置中的 gpt-6.1-terra 截图

来源与参考资料

同栏目 · 模型

Peter Walker / OpenRouter

OpenRouter:Anthropic 模型 7 日均 Token 量自 Opus 5.5 发布后涨约 3.6 倍

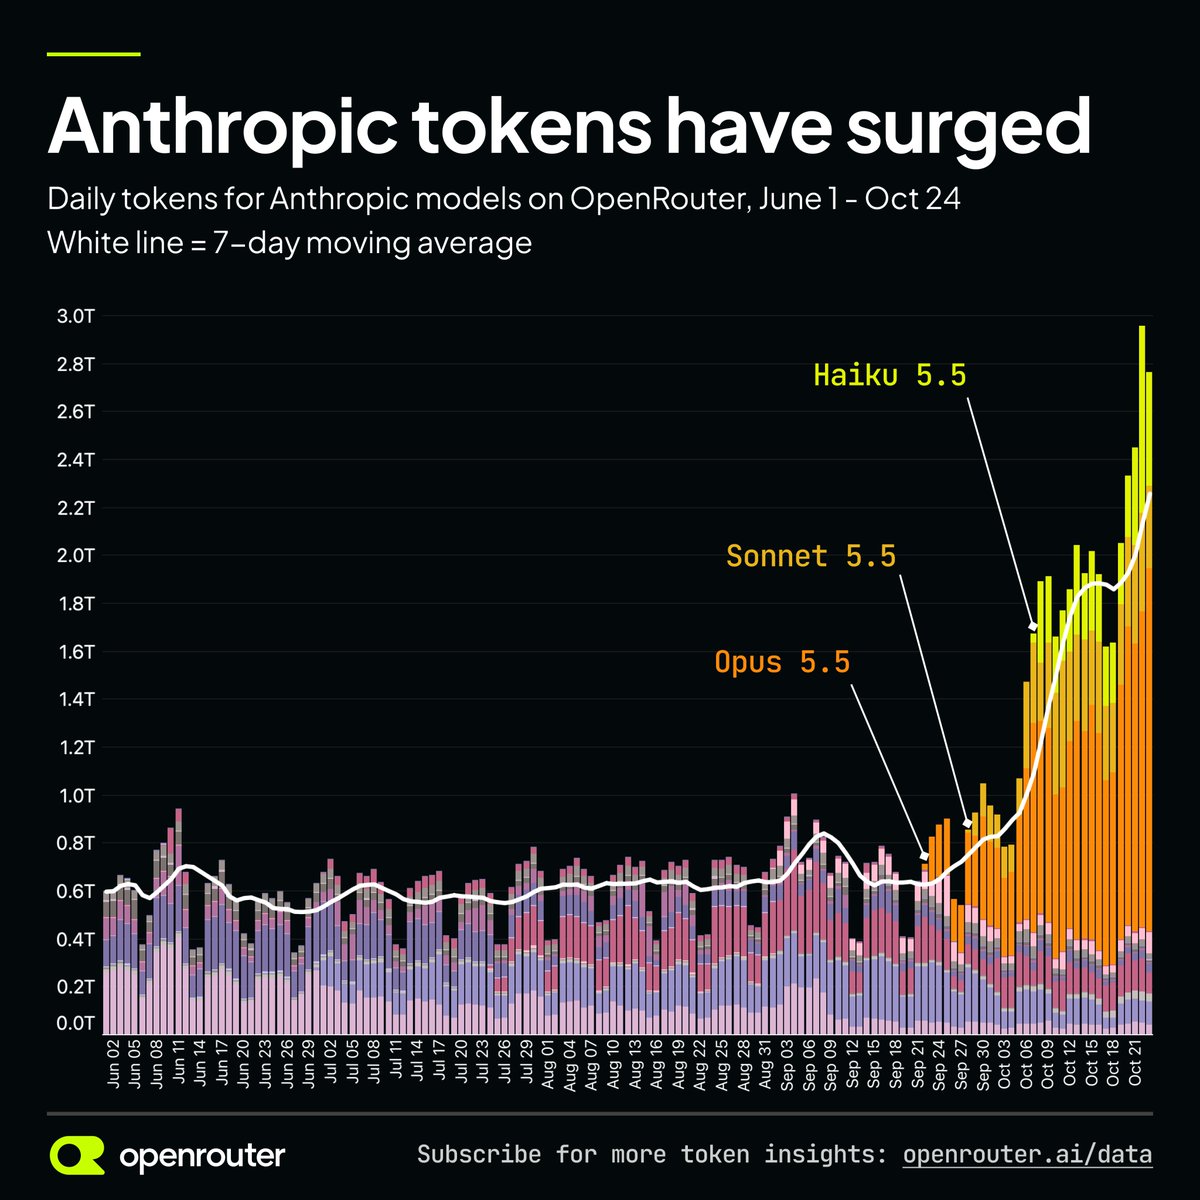
OpenRouter 数据显示,自 Claude Opus 5.5(约 9 月 22 日)上线以来,Anthropic 系模型的 7 日平均 Token 量上升约 3.6 倍;Sonnet 5.5 与 Haiku 5.5 同样获开发者青睐。

OpenRouter 图表:Anthropic 模型 7 日均 Token 量自 Opus 5.5 后显著上升
Nanbeige / Hugging Face

Nanbeige4.3-33B 开源:约 30B 档智能体编码多榜压过 Qwen3.8-27B

BOSS直聘旗下 Nanbeige LLM Lab 放出 Nanbeige4.3-33B(Apache 2.0):厂商自测 Terminal-Bench 2.1 得 80.9、DeepSWE 65.5,多数智能体编码/协作榜领先同级 Qwen3.8-27B、Muse Glimmer 30B 与 Gemma4-31B;定位为后续 3B 蒸馏的教师模型,上下文最高 512K。

Hugging Face 社交卡片:Nanbeige/Nanbeige4.3-33B
Canva Newsroom

Canva 发布自研图像模型 Craft:先构图规划再渲染,最高约 2K

Canva Research 推出首个自研图像生成模型 Craft:两阶段「规划→渲染」,支持 30+ 画幅与最高约 2K;已在 Canva 与公开 API 上线,并称在 DesignArena 等榜上靠前。

Canva 官方配图:Introducing Canva Craft