跳到正文
模型
模型 Moonshot / Kimi GPTClaudeDeepSeekKimiGLM

月之暗面:Kimi K3.1 Pro 上线,厂商称 Terminal-Bench 逼近 Opus 5.5

Moonshot 10 月 23 日发布 Kimi K3.1 Pro(及约 2–3× 速的 Highspeed):约 3T 级开源权重线的后训练升级,1M 上下文;今日起可在 Kimi.ai / Work / Code / API 用,完整权重计划 11 月 4 日放出。厂商称 Terminal-Bench 4.0 约 65.7%,略低于 Claude Opus 5.5 的 66.4%、高于 GPT-6 Astra 的 58.2%。

官方博客写明:K3.1 Pro 是 Kimi K3 的后训练加强版,面向编码、3D 创作、金融研究与 Agent;同步上线 Highspeed,自称同质约快 2–3 倍。可用性覆盖 Kimi.ai 与移动端、Kimi Work 3.1.0+、Kimi Code(/model)及 API(kimi-k3.1-pro / kimi-k3.1-pro-highspeed);Enterprise 默认关闭,需管理员开启。完整权重预计 2026-11-04 开放。

自测亮点(多为厂商 harness):Terminal-Bench 4.0 用 Claude Code harness 得 65.7%;Kimi Code Bench 3.0 Long-horizon 61.2%(相对 K3 的 55.95%);BenchCAD 带工具约 92.7%。安全侧称开源前从 mid-training 与 RL 环境剔除网攻相关数据:内部 xdev-bench-hard 上未剔除检查点约 90.5% pass@3,发布版约 81.0%,仍高于旧版 K3,但官方称故意压在闭源前沿之下。幻觉压力测(Kimi Hallu Bench Hard)称 claim 级幻觉率从 K3 的 23.4% 降到 8.3%。分数与网安口径均以厂商自测为主,第三方完整复现仍待跟进。
Kimi 官方配图:Introducing Kimi K3.1 Pro

来源与参考资料

同栏目 · 模型

Artificial Analysis

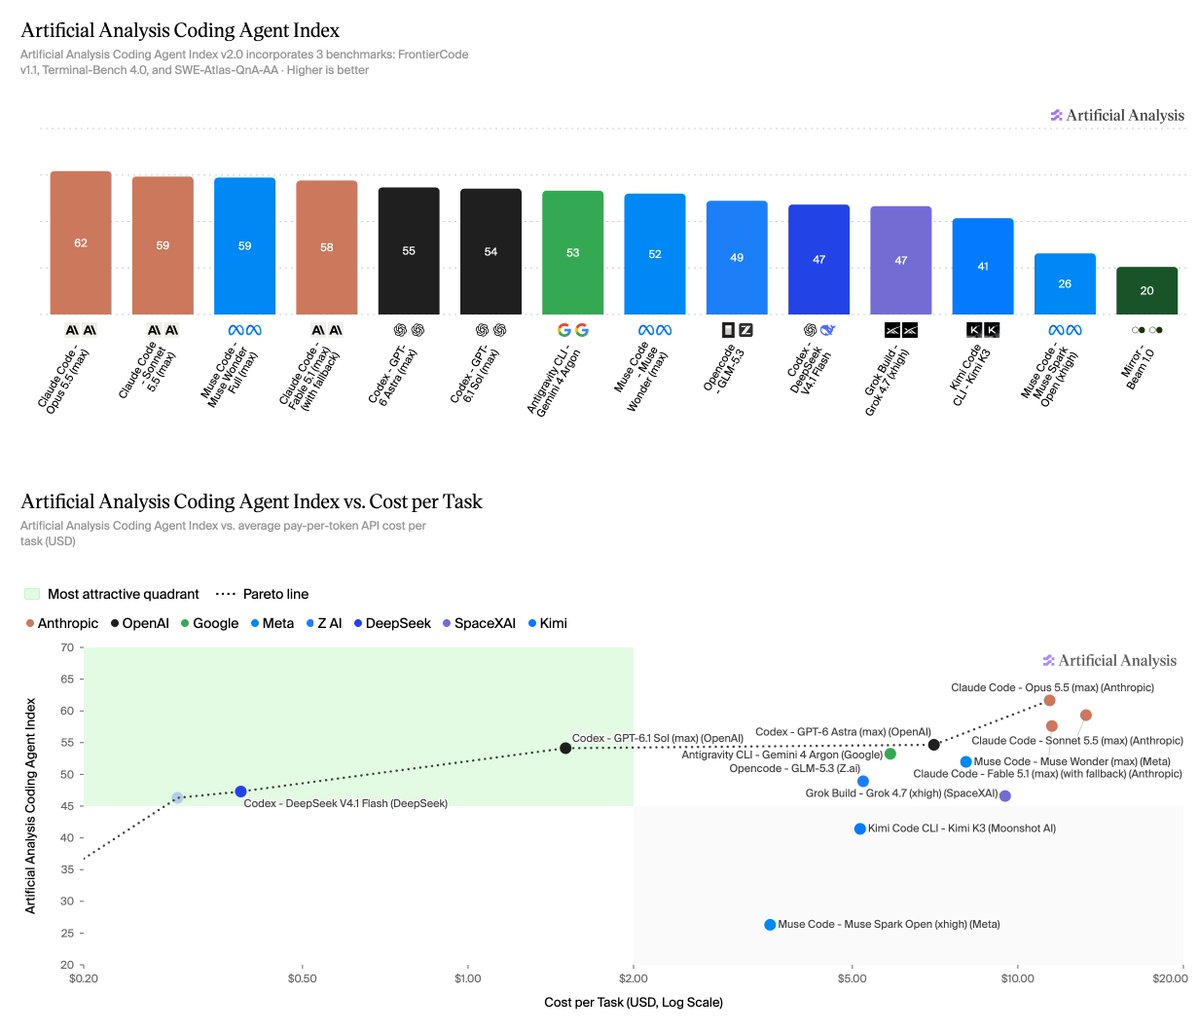
AA Coding Agent Index v2.0:Claude Opus 5.5 登顶 61.7,DeepSeek 性价比领跑

Artificial Analysis 10 月 23 日推出 Coding Agent Index v2.0:用 Cognition FrontierCode v1.1 替换 DeepSWE,并收紧仓库问答评分。Claude Code + Opus 5.5(max)以 61.7 居首;Codex + DeepSeek V4.1 Flash 约 $0.39/题、分 47.3,站在成本前沿。

Artificial Analysis Coding Agent Index v2.0 官方榜单配图
MiniMax / Hugging Face

MiniMax:M3.1 Flash 权重正式开源,428B/23B 激活

MiniMax 10 月 23 日放出 M3.1 Flash 权重:约 428B 总参、每 token 激活约 23B 的原生多模态 MoE,上下文最高 1M;官方称上线约 72 小时处理逾 100 万亿 token。权重见 Hugging Face,可接 SGLang / vLLM / TokenSpeed。

Hugging Face 社交卡片:MiniMaxAI/MiniMax-M3.1-Flash
Hugging Face / WIRED

Hugging Face 开源 Carbon-X:自然语言聊天就能问 DNA

Hugging Face 10 月 22 日放出约 14.8B 的 Carbon-X:基于 Qwen3-14B,把 DNA 与自然语言训进同一解码器;厂商称五项 DNA 基准均分 66.7%,逼近 GPT-6.1 Sol 的 67.5%,推理成本约低 1800 倍。Apache 2.0,单卡 80GB 可跑;未做临床验证。

Hugging Face 社交卡片:HuggingFaceBio/Carbon-X DNA 语言模型