跳到正文
芯片
芯片 NVIDIA Blog Gemini

Google Cloud A5X:Vera Rubin NVL72 机柜下月全面可用

NVIDIA 与 Google Cloud 10 月 21 日宣布:搭载 Vera Rubin NVL72 的 A5X 实例下月 GA,并规划扩至欧洲;公司称 Rubin 基础设施可扩到最多约 96 万颗 Rubin GPU,首批客户含 David Silver 的 Ineffable Intelligence。

A5X 把 NVIDIA Vera Rubin NVL72、ConnectX-9 SuperNIC、Google Cloud Virgo 网络与第四代液冷捆成一体,面向大规模 Agent 推理与强化学习。官方称 Google Cloud 计划把基于 Vera Rubin 的算力扩到多站点合计最多约 960,000 颗 Rubin GPU;London 的 Ineffable Intelligence(AlphaGo 创造者 David Silver 创办)已是首批接入方,用于持续从经验学习的「superlearner」研究。

同日还提到:WPP 在 A5X 上用 Nemotron 与 OpenShell 跑创意 Agent 参考架构;Google Cloud 将在 GB300 裸金属等实例上推进机柜级 Confidential Computing,并在 RTX PRO 6000 Blackwell 的 G4 虚拟机上对机密计算做 GA。面向云上训推与 RL 的机柜叙事,不是消费级产品上架。
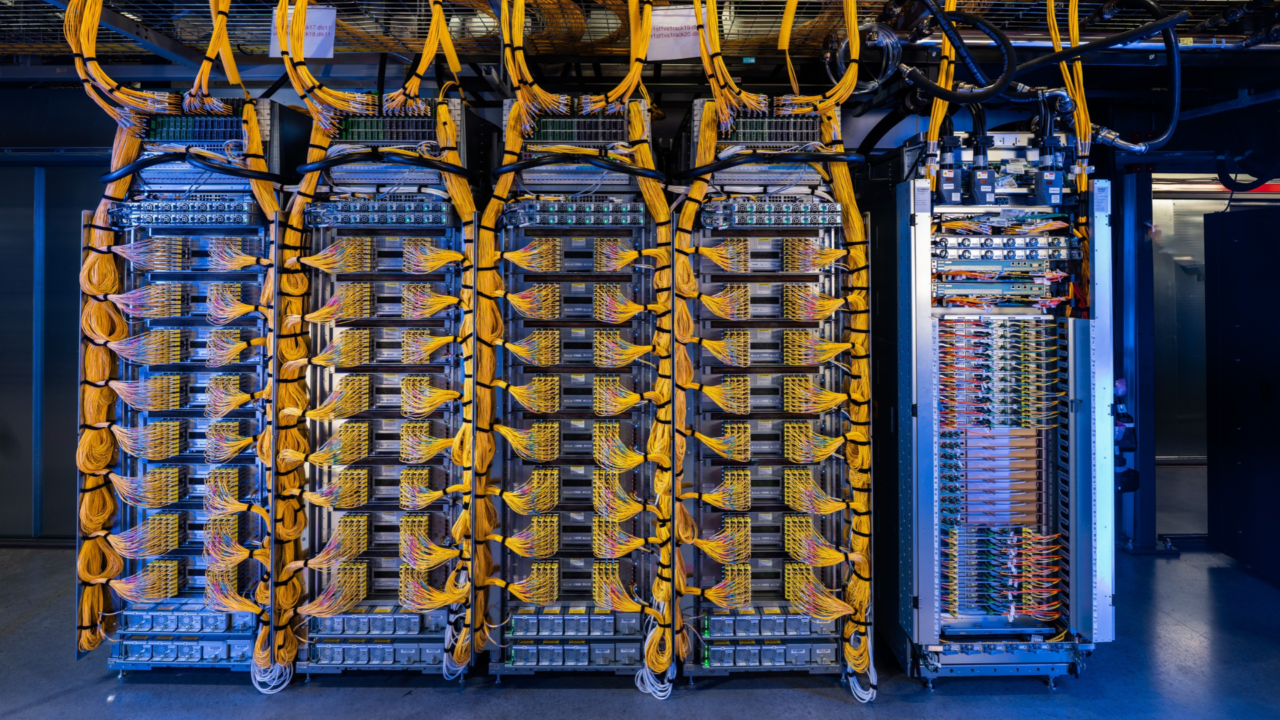
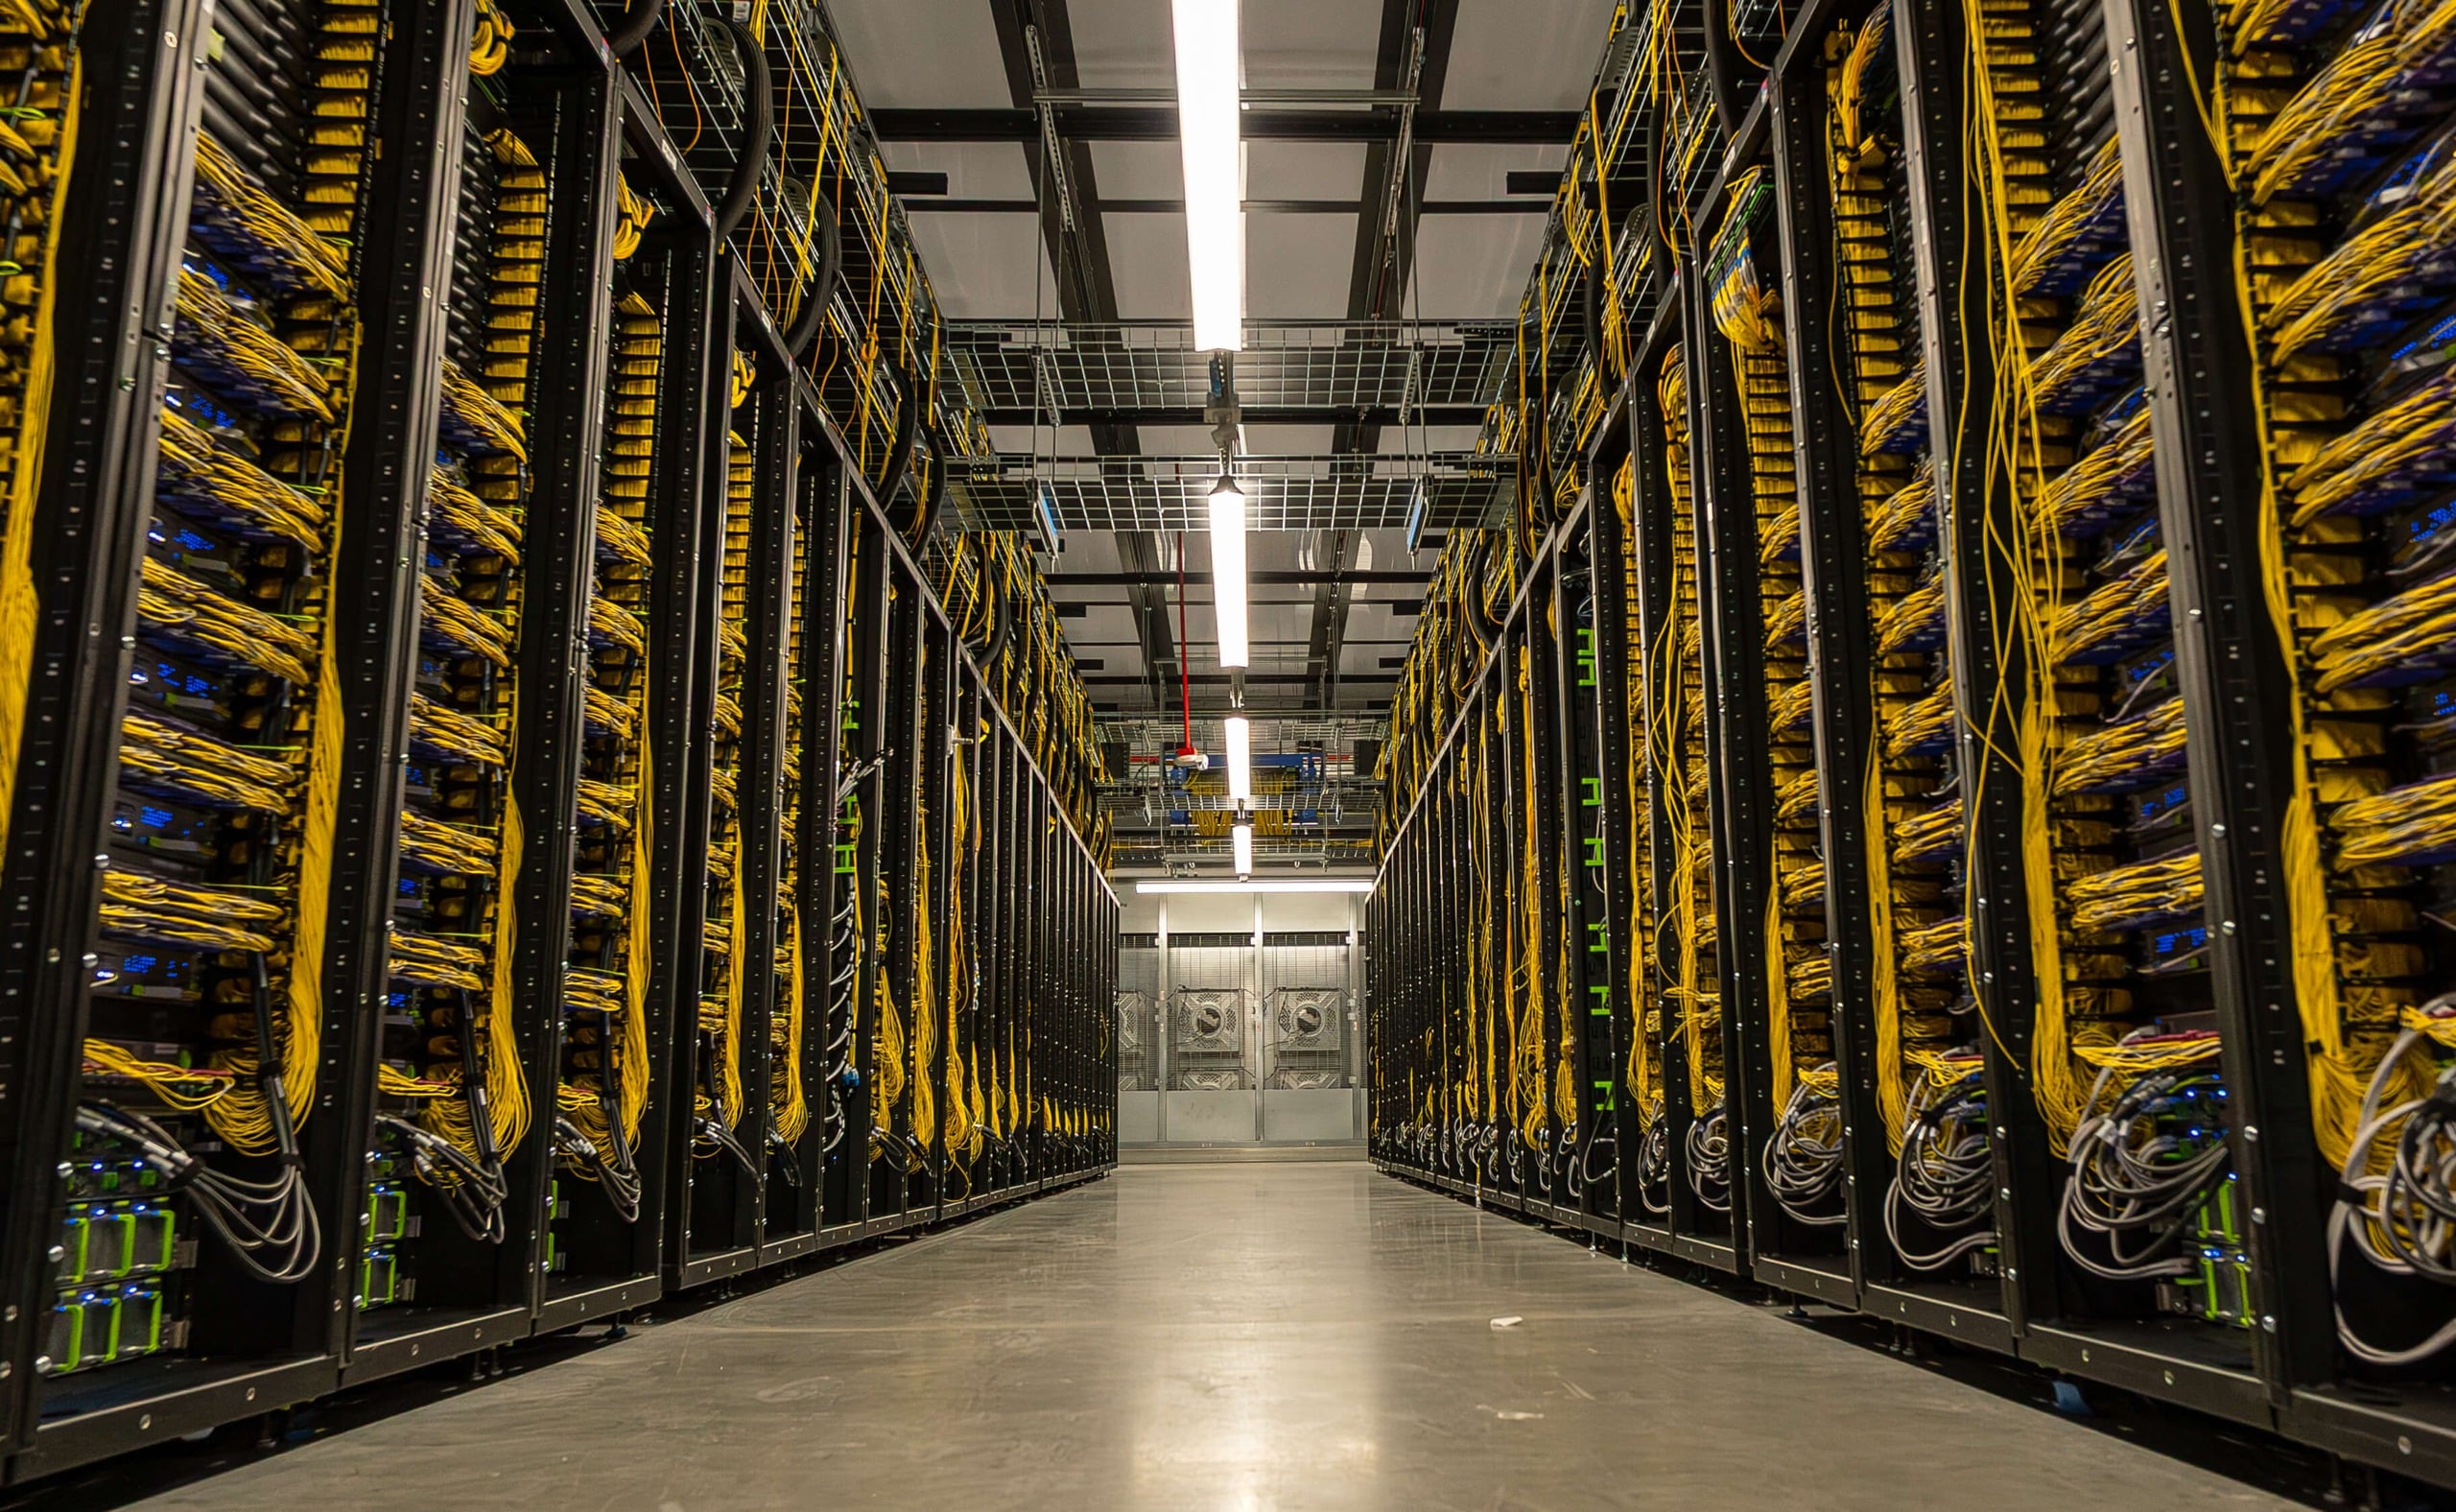
NVIDIA 官方配图:Google Cloud × Vera Rubin 基础设施

来源与参考资料

同栏目 · 芯片

Google Developers Blog

Google:vLLM / SGLang 原生 PyTorch 上 TPU,Qwen·DeepSeek·Kimi 等可跑

Google 开发者博客 10 月 20 日宣布基于 TorchTPU 的 vLLM-TorchTPU 与 SGLang-TorchTPU:用熟悉的 PyTorch 栈在 TPU 上做生产推理;已公开 SemiAnalysis InferenceX/AgentX 成绩,并称支持 Qwen、DeepSeek、GLM、Kimi、Gemma4 等主流开源族。

Google 官方配图:Announcing New vLLM and SGLang Inference Engines on TPU
Google Cloud Blog

Google 发布 llm-d 1.0:给 Agent 爆发流量用的开源分布式推理栈

Google 在 PyTorch Conference 发布 llm-d 1.0:Kubernetes 原生开源分布式推理栈(CNCF Sandbox),面向多步 Agent 与 RL rollout 的突发流量;与 Red Hat、IBM 等共建,已接 vLLM/SGLang 与 Cloud TPU/GPU。

Google Cloud 官方配图:AI infrastructure / llm-d 1.0
Meta Data Centers

Meta 公开 Ohio Prometheus 超算集群:训练 Muse Wonder 的千兆瓦级机房

Meta 数据中心博客 10 月 19 日介绍位于俄亥俄 New Albany 的 Prometheus 超级集群:为 Muse Wonder / Muse Wonder Full 等前沿模型提供训练算力,并规划向约百万级 GPU 扩展。

StorageReview 实拍:Meta New Albany Prometheus 机房冷通道