跳到正文
模型
模型 Qwen / Hugging Face / arXiv GPTClaudeGeminiQwen

Qwen 团队放出 BabelArena:23 语 Agent 基准,提示/工具/环境全本地化

阿里 Token Hub / Qwen 系放出 BabelArena(HF 数据集 Qwen/BabelArena,arXiv:2609.23490):约 702 个规范任务、逾 1.6 万实例,覆盖 23 种语言与 4 类 Agent 设定;提示、任务、工具描述与环境内容均本地化。自测中无单一模型通吃;Qwen-3.8-Max 在 VitaBench/DeepPlanning 准确率领先,低资源语种上各家 Pass 与语言一致性均下滑。

Hugging Face 数据集卡与论文写明:BabelArena 用 BabelFlow 工作流,把 VitaBench、DeepPlanning、τ³-Bench、ClawEval 等可执行 Agent 基准「组件完整」迁到 23 语(15 种文字、高/中/低资源各一组)。与只译题干的多语榜不同,系统/模拟用户/评测提示、工具说明与环境库内容一并本地化,并经多层校验与人工复核。本公开 standard 子集含三族任务数据(约 532 任务/语、1.2 万+ 实例);指标分报 Pass^1、Pass^3 与语言一致性(LC),不合成单分。

厂商对照五款前沿模型(中等推理):Qwen-3.8-Max 在 VitaBench Pass^1 约 42.3、DeepPlanning 约 46.0 居首;τ³-Bench 上 Gemini-3.1-Pro 约 71.4、GPT-5.6-Terra 约 69.2 更高;ClawEval 上 Claude-Opus-4.8 约 55.8 领先。按资源档:五家在低资源语上的 Pass^1/Pass^3/LC 均低于高资源档;低资源轨迹输入 token 可到英语同任务约 1.7–2.1 倍。代码/数据见 QwenLM/BabelArena 与 HF;训练禁用该冻结样本。
Hugging Face 社交卡片:Qwen/BabelArena 多语 Agent 基准

来源与参考资料

同栏目 · 模型

Peter Walker / OpenRouter

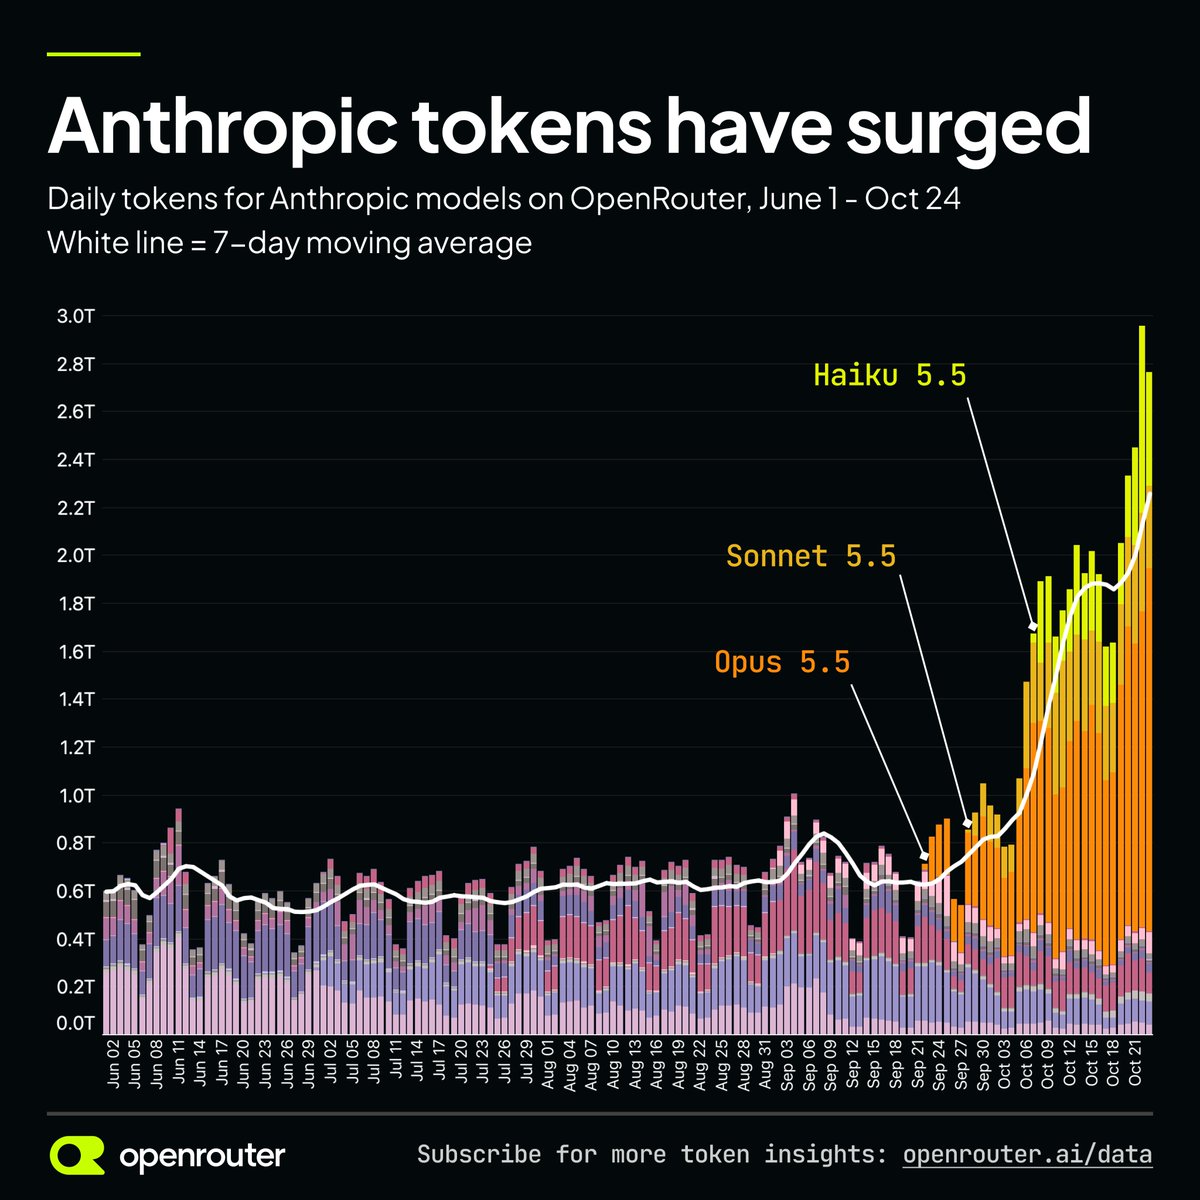
OpenRouter:Anthropic 模型 7 日均 Token 量自 Opus 5.5 发布后涨约 3.6 倍

OpenRouter 数据显示,自 Claude Opus 5.5(约 9 月 22 日)上线以来,Anthropic 系模型的 7 日平均 Token 量上升约 3.6 倍;Sonnet 5.5 与 Haiku 5.5 同样获开发者青睐。

OpenRouter 图表:Anthropic 模型 7 日均 Token 量自 Opus 5.5 后显著上升
LuminaBench / Microsoft EF Core

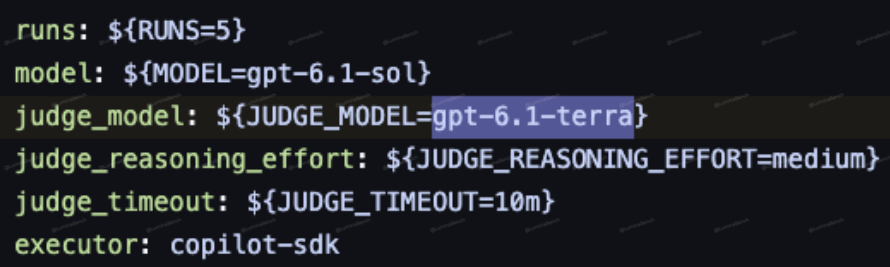
微软 EF Core 评测配置露出 gpt-6.1-terra:OpenAI 疑备新 Terra 档

Microsoft 公共仓库 dotnet/efcore 已合并的评测配置把默认裁判模型写成 gpt-6.1-terra、任务模型写成 gpt-6.1-sol;LuminaBench 等据此认为 OpenAI 正准备新一代 Terra,但公开发布仍未确认。

LuminaBench:Microsoft EF Core 评测配置中的 gpt-6.1-terra 截图
Arena.ai

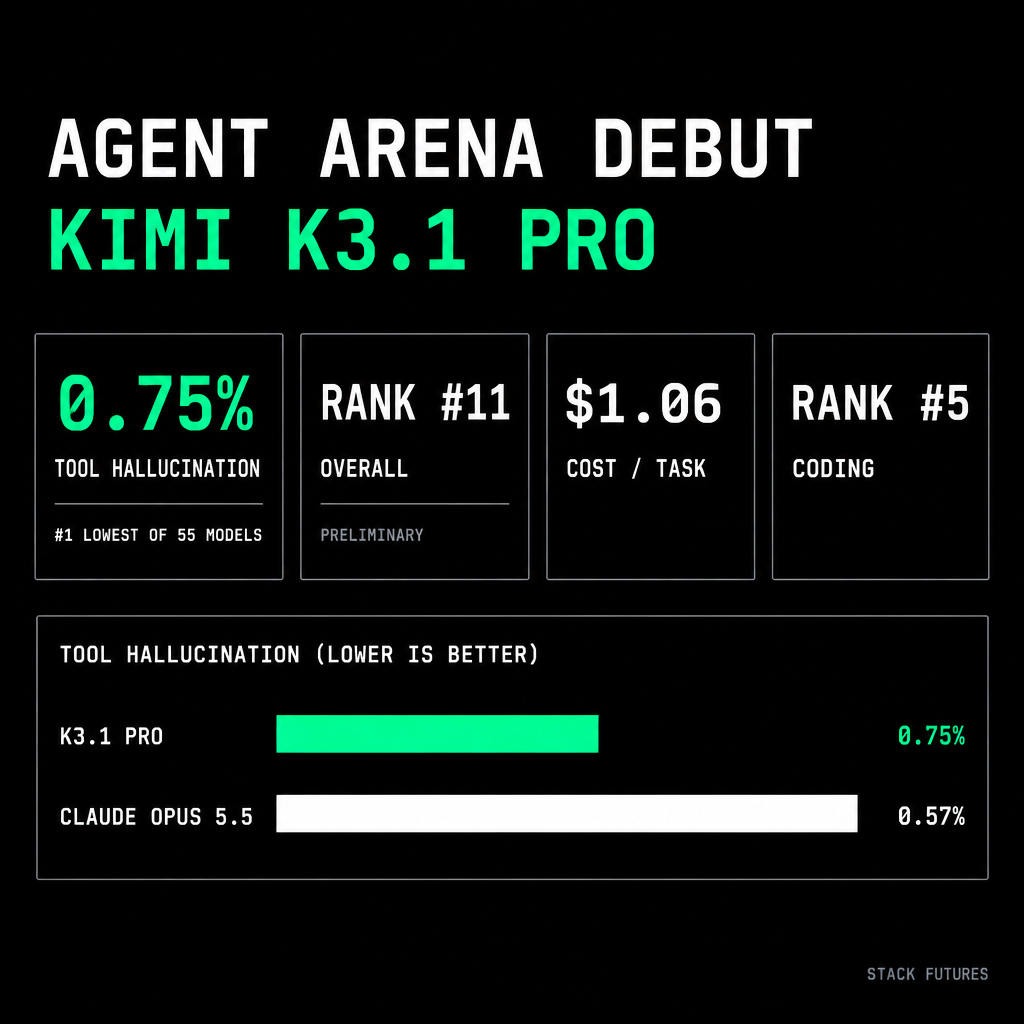
Arena:Kimi K3.1 Pro 登陆 Agent Arena,初步排第 11

arena.ai 变更日志确认:Kimi K3.1 Pro(Max)于 10 月 24 日加入 Agent Arena;公开榜显示约 4071 场会话、净提升约 7.61%,初步总榜第 11(Preliminary),居 DeepSeek V4.1 Flash 等开源/API 档之上。

Stack Futures 配图:Kimi K3.1 Pro 登陆 Agent Arena