跳到正文
模型
模型 GVS5H / Hacker News / Tensorust ClaudeQwenDeepSeek

GVS5H:五份 Qwen3.8-27B 自编排,LiveCodeBench Hard 打平 Fable 5

Persis Capital 论文/开源仓 GVS5H(10 月 25 日冲上 HN):账本式自编排让五份 Qwen3.8-27B 在 100 道新硬题上 pass@1 从 66.8% 提到 92.4%,对照单次调用的 Claude Fable 5 为 90.4%(统计上打平)。第三方复盘强调旧基准污染与未给 Fable 挂同一 harness。

作者把方法叫 ledger-based self-orchestration:同一底座的多份新鲜上下文通过共享目录里的 plan.md、notes.md、tasks.json、solution.py 等协调,最多约 10 轮经理—工人循环,并用公开测试反馈。主表(作者 harness):Qwen3.8-27B 单模型 66.8%,五工人管理器 92.4%;Fable 5 仅单次调用 90.4%。同文还测了 DeepSeek-V4.1-Flash 等;作者给出 Fable 单遍约 $61、Qwen 管理器按当时自建价更低等成本表。

局限需写清:评测是 LiveCodeBench 一类偏算法谜题的旧硬题集,不是真实仓库 Agent 任务;Fable 5 未挂同一编排环,也未对照更新的 Astra / Sol / Opus 5.5 / Fable 5.1。HN 讨论指出可能污染、量化不一致与「harness 刷榜」风险。Tensorust 10 月 25 日按论文 token 量重算 OpenRouter 上 21 个 Qwen3.8-27B 端点,称该遍成本中位约 $42.90、最便宜 FP8 约 $23.34,均低于文中 Fable 的 $61.11——价格对比依赖论文 token 统计,解读宜收在「编排 + 开源价」信号,而非「27B 已碾压前沿」。
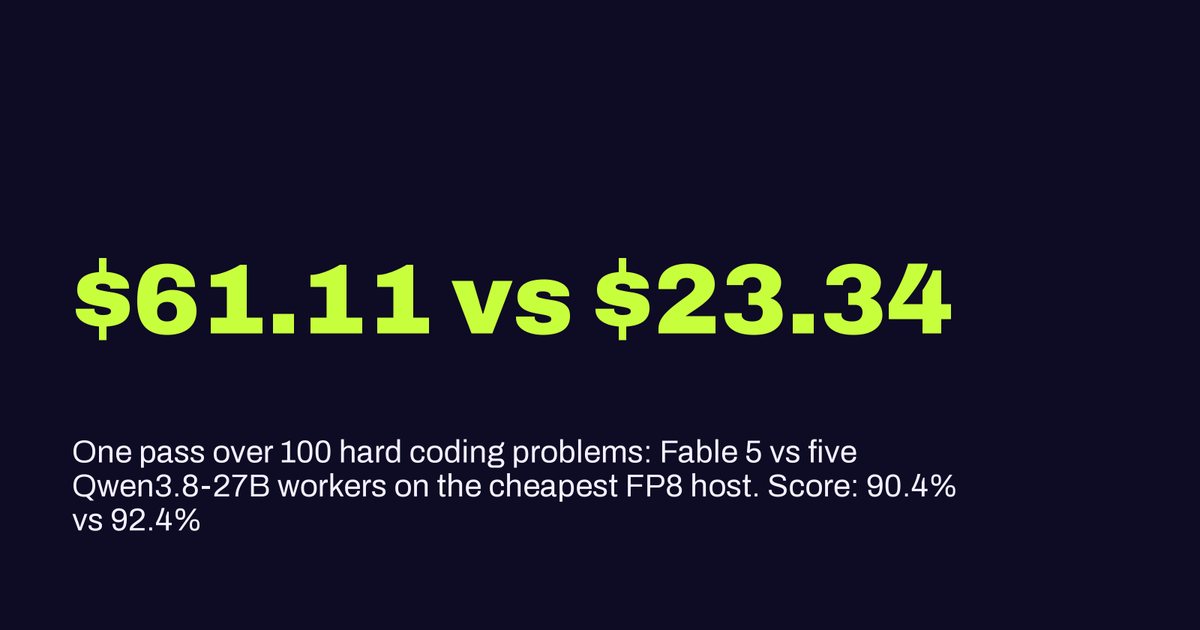
Tensorust 配图:Qwen3.8-27B 与 Fable 5 成本对比

来源与参考资料

同栏目 · 模型

Peter Walker / OpenRouter

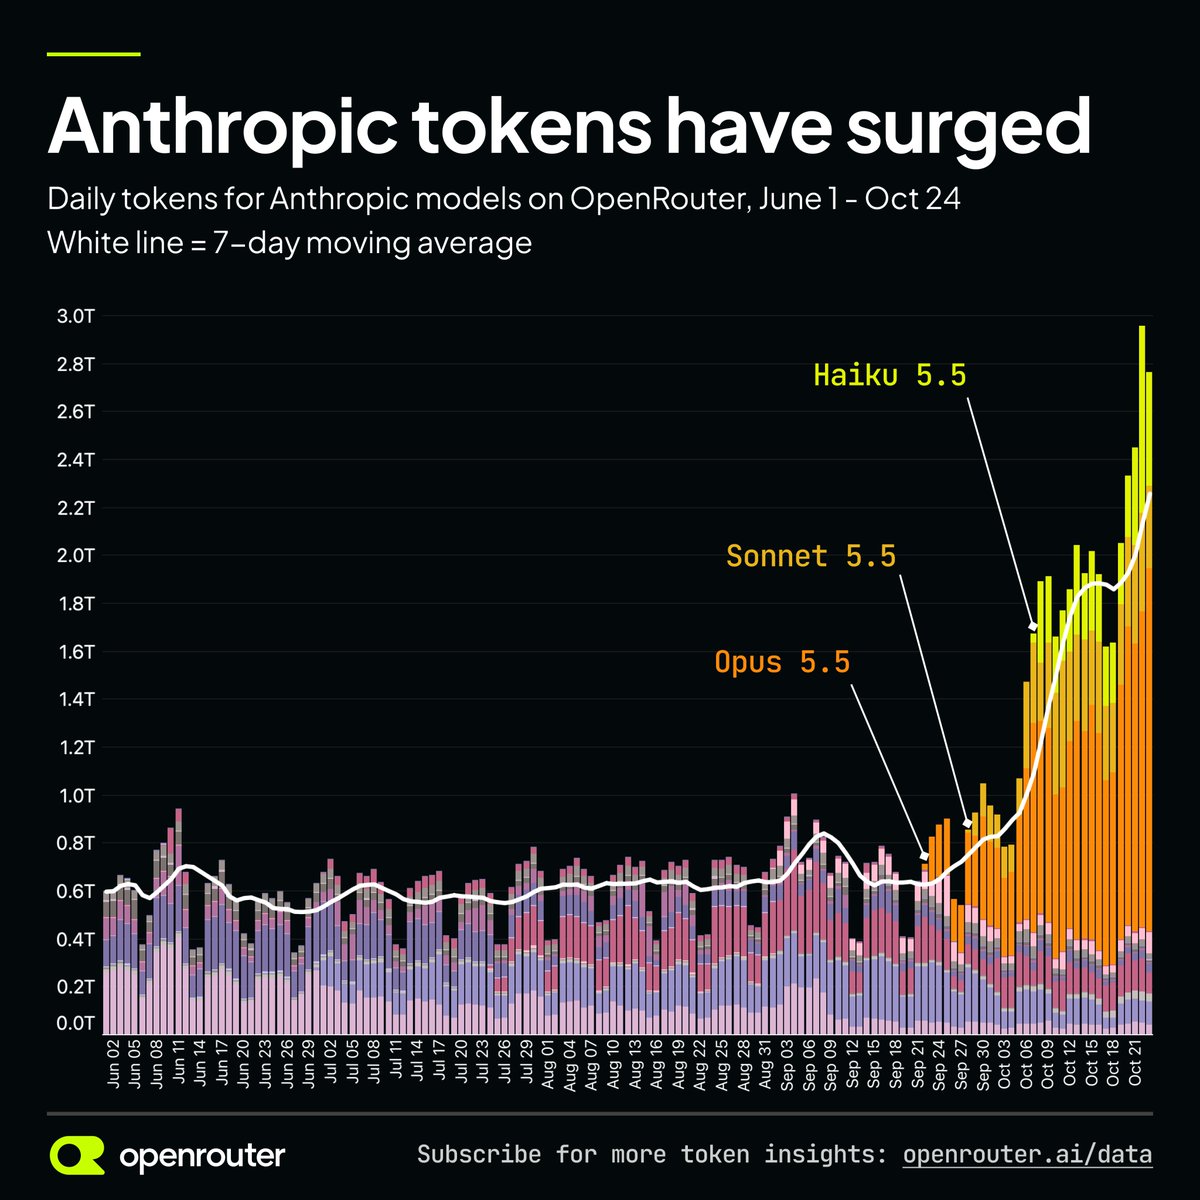
OpenRouter:Anthropic 模型 7 日均 Token 量自 Opus 5.5 发布后涨约 3.6 倍

OpenRouter 数据显示,自 Claude Opus 5.5(约 9 月 22 日)上线以来,Anthropic 系模型的 7 日平均 Token 量上升约 3.6 倍;Sonnet 5.5 与 Haiku 5.5 同样获开发者青睐。

OpenRouter 图表:Anthropic 模型 7 日均 Token 量自 Opus 5.5 后显著上升
LuminaBench / Microsoft EF Core

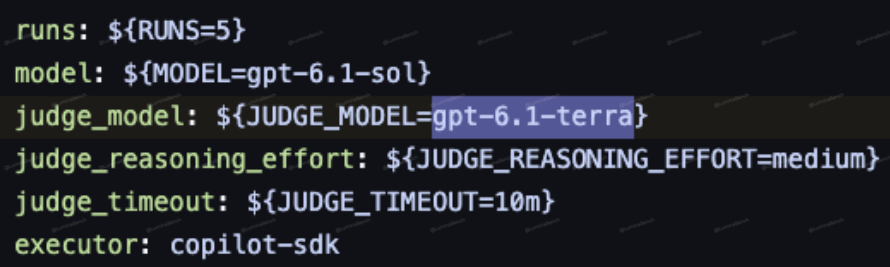
微软 EF Core 评测配置露出 gpt-6.1-terra:OpenAI 疑备新 Terra 档

Microsoft 公共仓库 dotnet/efcore 已合并的评测配置把默认裁判模型写成 gpt-6.1-terra、任务模型写成 gpt-6.1-sol;LuminaBench 等据此认为 OpenAI 正准备新一代 Terra,但公开发布仍未确认。

LuminaBench:Microsoft EF Core 评测配置中的 gpt-6.1-terra 截图
Arena.ai

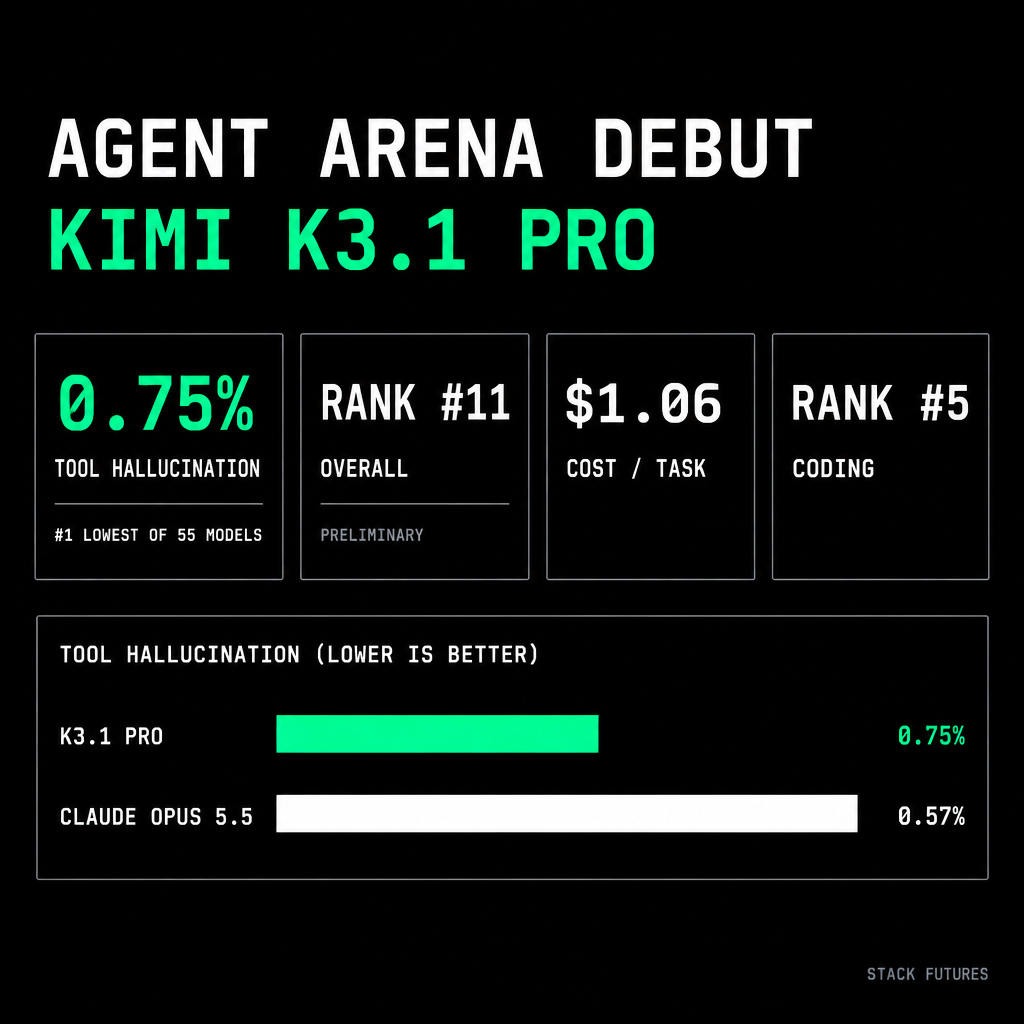
Arena:Kimi K3.1 Pro 登陆 Agent Arena,初步排第 11

arena.ai 变更日志确认:Kimi K3.1 Pro(Max)于 10 月 24 日加入 Agent Arena;公开榜显示约 4071 场会话、净提升约 7.61%,初步总榜第 11(Preliminary),居 DeepSeek V4.1 Flash 等开源/API 档之上。

Stack Futures 配图:Kimi K3.1 Pro 登陆 Agent Arena