整理:TopAIMap 编辑
Liquid AI 发布 d1-ultra:多模态决策模型登顶 AA Decision Index(约 65 分),仅收输入 $0.042/M、零输出 token
Liquid AI 于 10 月 15 日发布 d1-ultra,一次前向返回是/否、多选、打分的校准概率(不生成文本);Artificial Analysis 10 月 16 日确认其位列 Decision Index v1.0 榜首(约 65 分,领先 Jev 等至少约 8 分)。API 现已开放,输入 $0.042/百万 token、输出不计费,OpenRouter/Vercel Gateway 已上架。
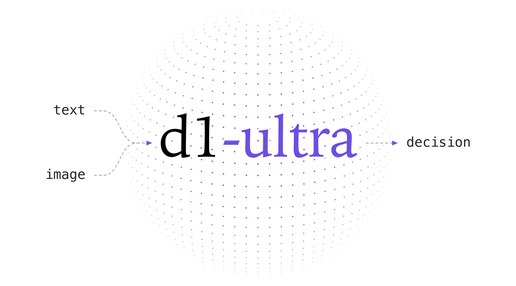
10 月 15 日(美西),Liquid AI 官宣发布多模态决策模型 d1-ultra;10 月 16 日约 4:11am PT,评测方 Artificial Analysis 官方账号确认其登上 Artificial Analysis Decision Index v1.0 榜首(约 65 分,至少领先第二名约 8 分)。决策模型不做逐字生成:一次前向把文本/图像 + 结构化问题读完,直接返回各选项的校准概率。定价为每百万输入 token 0.042 美元,输出不计费;Liquid 博客写明即将上 Vercel AI Gateway 与 OpenRouter(Vercel Developers 已挂 liquid/d1-ultra)。
条件与影响:题型沿用 d1 的三种——noul(是/否概率)、Choice(多标签概率)、Score(量表)。官方对标 TypeSafe Jev 1.14,称在 112 项评测上全面胜出,并强调多数决策模型过度自信,故专门训了校准。独立口径来自 AA Decision Index(知识/幻觉、HLE 多选、When2Call、WildGuard 等加权);AA 快照里 d1-ultra 约 65.2,Jev 1.13/1.14 约 57 一带。上下文约 32K;图像按 32×32 patch 计输入(例:1024×1024 ≈ 1536 token)。这不是通用聊天旗舰,也不开源权重——是 API 决策端点。
谁能用:Liquid API(需 API Key)现已可用;OpenRouter 上模型名 liquid/d1-ultra,System One / Decisions 端点(不是普通 chat completions);Vercel AI Gateway 亦已挂载。计费只收输入、输出免费,适合高吞吐分类/路由/审核。没有 ChatGPT 式 Free/Pro/Ultra 聊天档,也不是 Antigravity/IDE 内置默认模型——开发者与企业走 API/网关接入。支持 44 种语言;多模态文本+图像同请求。
真实用法:产线质检(电路板照片对照规格判缺陷)、理赔核验(客户照片 vs 保单描述)、内容审核与工具调用前的「该不该调工具」门控、多标签路由。团队把「要不要、选哪个、打几分」从长文本聊天里拆出来,用概率接口省输出 token、压延迟。Shopify 等客户已公开用 Liquid 系模型做规模化部署;决策模型这条线更偏结构化流水线,而不是对话助手。
解读:通用 LLM 卷完以后,「只拍板、不聊天」的决策模型正在单独成榜——Jev、Cloudflare Clef、Microsoft Decision、Liquid d1 系列同台比校准与幻觉。d1-ultra 用「同价更高校准 + AA 榜首」抢位。讨论:1. 你会把分类/路由从 Opus/Argon 长上下文里拆到 d1-ultra 这类零输出决策端点吗?2. 决策榜领先 8 分,对你更重要的是校准可靠性,还是仍要看自己业务集上的误杀率?
来源:Liquid AI Blog · https://www.liquid.ai/blog/d1-ultra · Artificial Analysis · https://x.com/ArtificialAnlys/status/2111052531166249039 · OpenRouter https://openrouter.ai/liquid/d1-ultra · Vercel https://x.com/vercel_dev/status/2110885005560094768 · AA Decision Index https://artificialanalysis.ai/evaluations/artificial-analysis-decision-index