整理:TopAIMap 编辑
腾讯混元开源 Hy Memory 2.0:记忆专用模型 Hy-Memory-30B-A3B(约 3B 激活)+ SDK + MemHub,自测四套框架均分超 Opus 5
腾讯混元 10 月 16 日宣布开源 Hy Memory 2.0 全栈:记忆写入专用模型 Hy-Memory-30B-A3B(Apache-2.0,HF/PyPI/GitHub)、双系统记忆引擎 SDK,以及本地优先的 MemHub(CLI+Mac),可跨 Cursor/Claude Code/Codex 等 10+ 工具同步记忆。官方称在 Mem0/MemOS/EverMemOS/Hy Memory 四套系统上均分 55.49,略超 Opus 5 的 54.62,MemoryArena 领先约 10.2 分。
10 月 16 日上午(北京时间,太平洋时间约 2:22–2:32am),腾讯混元官方账号 @TencentHunyuan 与 @TencentAI_News 同步宣布开源 Hy Memory 2.0:一次性放出记忆写入专用模型 Hy-Memory-30B-A3B、Python SDK(hy-memory==2.0.1)以及本地优先产品 MemHub。仓库在 GitHub Tencent-Hunyuan/Hy-Memory,权重在 Hugging Face tencent/Hy-Memory-30B-A3B,技术报告 arXiv:2610.22196,官网 memory.hunyuan.tencent.com。官方帖发布后数小时内点赞过百、GitHub 星标约 50(仍在快速上升)。
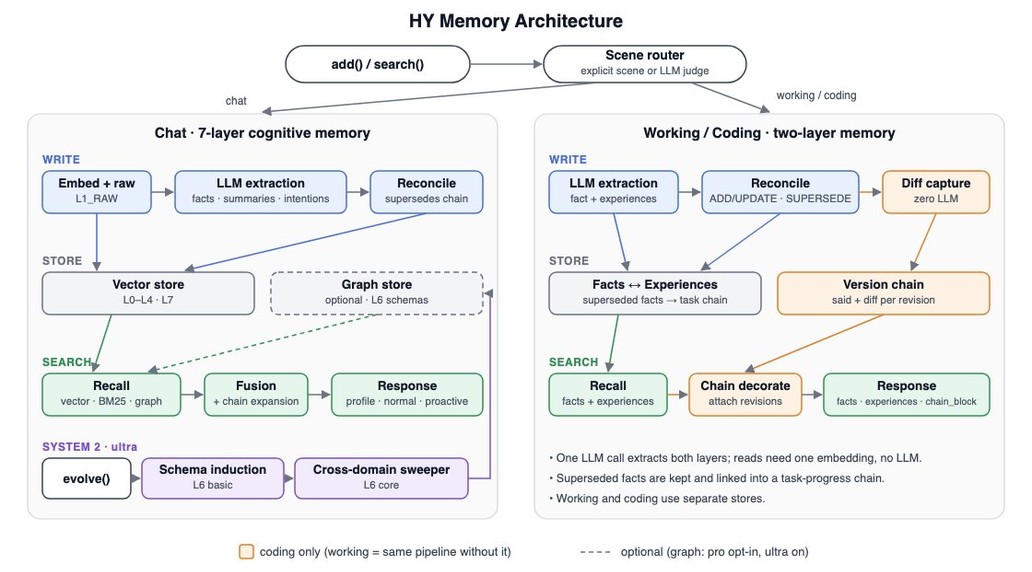
条件与影响:Hy-Memory-30B-A3B 是「记忆写入器」而非通用聊天旗舰——论文标题强调 Attributed Reinforcement Learning for Long-Term Memory Writing,面向 Mem0、MemOS、Hy Memory 等框架的写路径(决定留什么、怎么表示、如何更新持久状态)。官方宣传口径称约 3B 激活参数的 30B-A3B 在四套记忆系统平均分 55.49,略高于 Opus 5 的 54.62,MemoryArena 领先约 10.2 分,并称记忆体积减少约 51.8%、召回 token 降低约 39.3%;这些数字来自腾讯自测/官宣,独立第三方复现尚未铺开。引擎覆盖 Chat / Working / Coding 三条记忆管线;MemHub 统一导入授权后的对话与编码轨迹。许可证为 Apache-2.0。
谁能用:权重与代码均 Apache-2.0 开源,可商用自托管——开发者可从 Hugging Face 拉 Hy-Memory-30B-A3B,用 PyPI 的 hy-memory SDK 接进自有 Agent;MemHub 提供 CLI 与 Mac 客户端,官方点名支持 Claude Code、Cursor、Codex、OpenCode、Qwen Code 等 10+ 工具的本地优先记忆同步(需用户授权导入)。没有单独的「混元 App 内一键订阅档」作为本产品主入口;这不是 ChatGPT/Claude 那种 Free/Pro/Ultra 对话面,而是开源栈 + 本地工具。企业若要闭源混元对话大模型本身,仍走腾讯云/混元既有 API 与企业授权,与本次记忆栈开源是两条线。
真实用法:Agent 团队可把 Hy Memory 当作跨会话的「私人记忆管家」——聊天长期认知记忆、工作事实与可复用经验、编码场景的版本 diff 链;MemHub 把多人在 Cursor/Claude Code 里散落的上下文收拢到本地目录再召回,减少「换工具就失忆」。也可只取一层:只跑模型当 Mem0/MemOS 的写模型,或只用 SDK 不做桌面端。社区当天已有开发者 bookmark「专门做记忆管理的开源模型」,对比路径是 Mem0/MemOS/EverMemOS 与闭源 Opus 写记忆的成本。
解读:通用模型卷完以后,下一刀砍在「Agent 能不能长期记得」——腾讯选择开源「写记忆专用小激活模型 + 框架 + 本地壳」,用开源对冲闭源旗舰在记忆中间件上的黏性。自测赢 Opus 5 的叙事很抓眼球,但口径是记忆基准而非综合智力榜,采购前仍要在自己的 harness 与数据上复测。讨论:1. 你会先把 MemHub 接到现有 Cursor/Claude Code 工作流,还是只把 Hy-Memory-30B-A3B 塞进自建 Mem0?2. 若记忆体积真能砍半,团队更在意召回质量,还是跨工具同步的隐私边界?
来源:Tencent Hunyuan / Tencent AI News · https://x.com/TencentHunyuan/status/2111027329816465435 · GitHub https://github.com/Tencent-Hunyuan/Hy-Memory · HF https://huggingface.co/tencent/Hy-Memory-30B-A3B · 论文 https://arxiv.org/abs/2610.22196 · 官网 https://memory.hunyuan.tencent.com/