整理:TopAIMap 编辑
Z.ai GLM-Legal 上线:Harvey LAB 全通过率 19.17%,Vals 排第 7/79
Z.ai 发布法律专项模型 GLM-Legal(基于 GLM-5.3-Flash);Vals 测 Harvey LAB 19.17% 第7/79;API 申请制 beta,将接 AutoClaw。
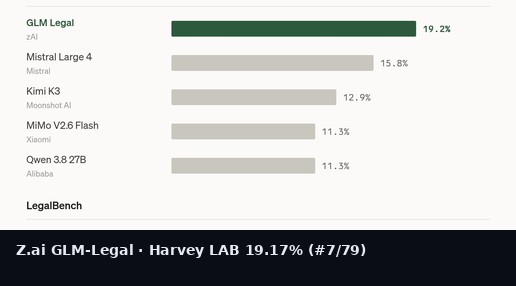
Z.ai(智谱海外品牌)于 2026-10-12 发布法律专项模型 GLM-Legal,基于开源基座 GLM-5.3-Flash(320B/18B MoE,1M 上下文)做法律语料中训与强化学习后训,面向合同审阅、证据分析、合规调研等可交付工作流。独立评测方 Vals AI 在 Harvey Legal Agent Benchmark(全通过计分)给出 19.17%,位列 79 个模型中第 7;基座同测仅 6.67%。LegalBench 约 86.23%。官方 X 帖互动约 7.6k likes / 78 万展示。
谁能用:目前以 API 申请制 beta 为主(https://z.ai/consultation/legal);官方称将接入桌面 Agent 平台 AutoClaw(autoclaw.z.ai),未给公开日期。公开权重与 GLM-Legal 官方标价未见;Vals 测跑记入约 $0.07/$0.25 每百万 token、单次 Harvey LAB 任务约 $0.15。基座 GLM-5.3-Flash 仍可走公开 API / HF。 解读:法律 Agent 榜上「专用模型」用全通过严规把分数打到接近 Muse/Gemini 前列,但距 Muse Spark 1.2 的 25.42% 仍有缺口;慢(Vals 平均约 1h12m/任务)和申请制会限制试用扩散。 讨论:① 律所会更信「严规全通过」还是「单条准则通过率」?② 领域特化是否会成为下一波叙事,还是继续被通用前沿模型吞掉? 来源:Z.ai https://x.com/Zai_org/status/2109678174468534511 | Tech Blog https://z.ai/blog/glm-legal | Apply https://z.ai/consultation/legal | Vals https://www.vals.ai/models/zai_glm-legal | Vals 确认帖 https://x.com/ValsAI/status/2109678919108690380 | MarkTechPost https://www.marktechpost.com/2026/10/13/zai-glm-legal-harvey-lab-legal-ai-model/
参考资料