整理:TopAIMap 编辑
小米 MiMo-V2.6-Pro 登顶 Arena「Agent Arena」开源榜第一:净提升 +3.8%,单任务成本约 0.11 美元
10 月 15 日(PT)中午 12:32,评测平台 Arena(原 LMArena)官宣:在 Bash 可靠性信号改版后的 Agent Arena 排名中,小米 MiMo-V2.6-Pro 以 +3.8% 净提升拿下开源模型第一,DeepSeek-V4.1 Flash(Max)+3.0%、腾讯 Hy4 preview +2.9%、MiMo-V2.6 Flash +2.5%、GLM-5.2(Max)+2.4% 紧随其后,Kimi K3(Max)+1.9% 排第 7,Qwen3.8-Flash-Next 为 −2.6%。Arena 原帖约 2.7 万浏览、224 赞,中文圈转述贴也在晚间持续扩散。
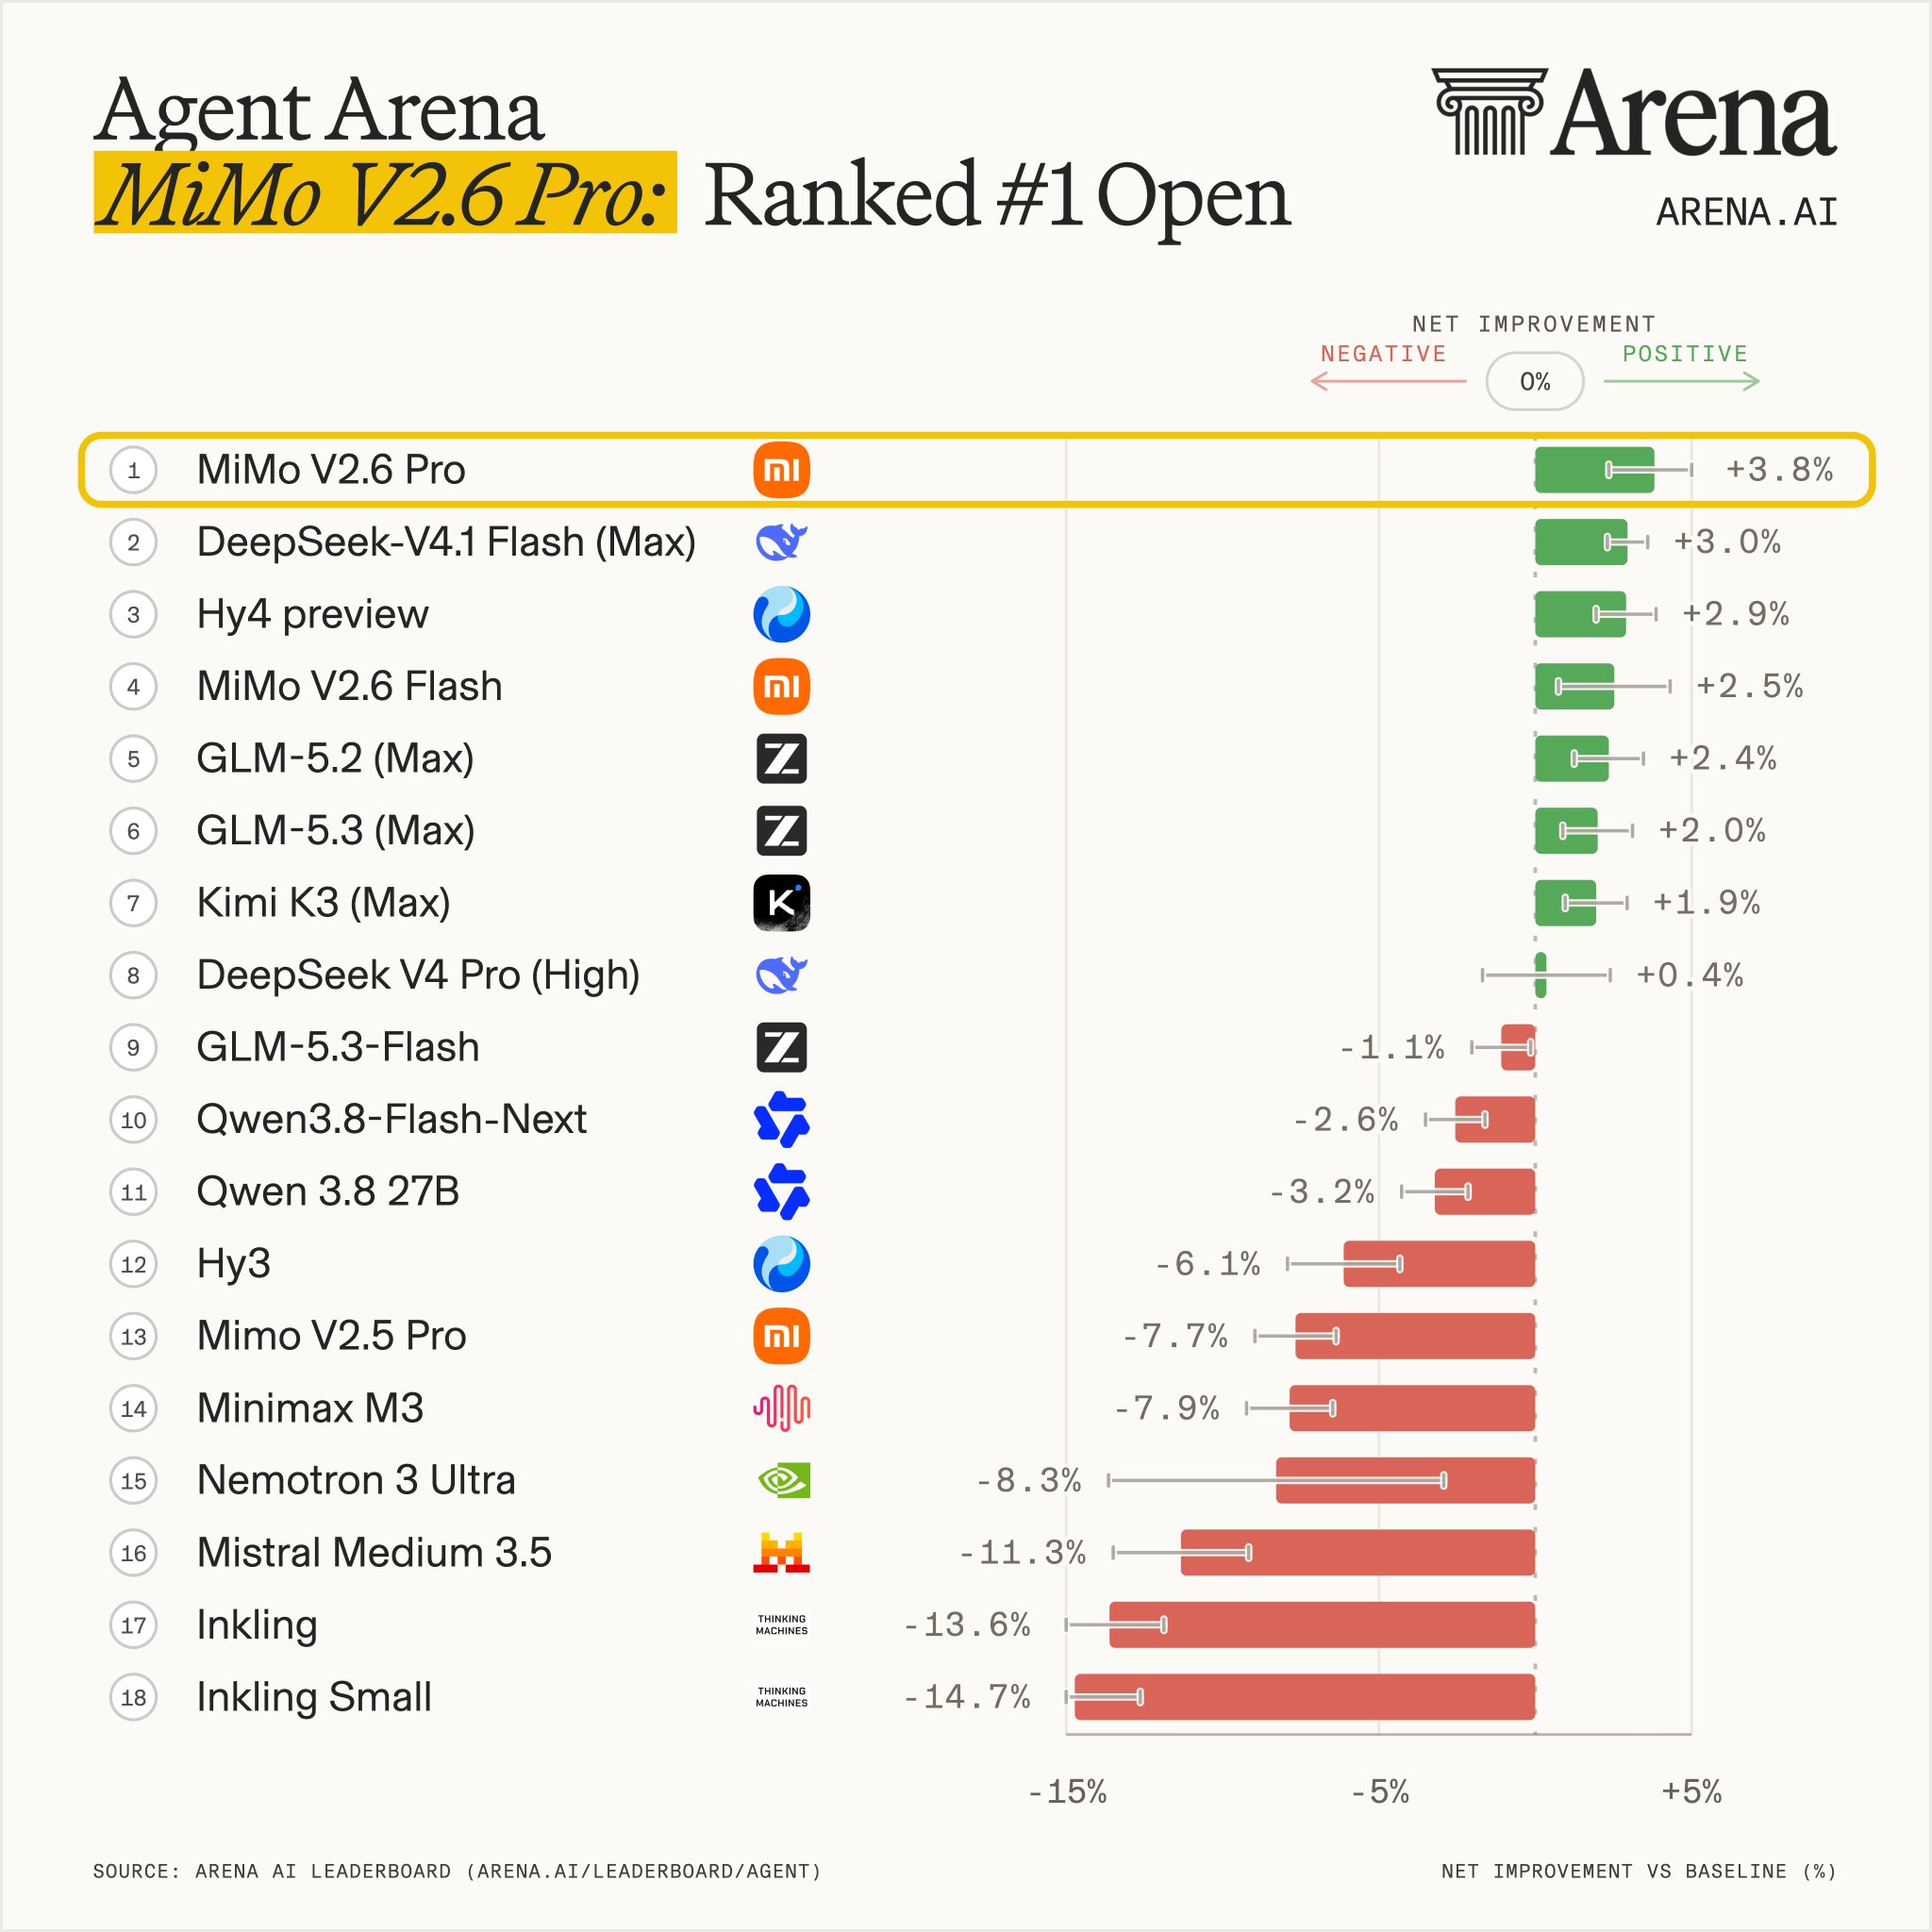
Agent Arena 不是静态题库:用户把真实的长链路任务(可用联网搜索、文件系统和终端)交给模型,再确认结果是否满足需求,Arena 以「相对基线的净提升」排序。10 月 13 日它把 Bash Recovery 升级为 Bash Reliability——逐条读每次 bash 调用的目的、结果、报错原因,以及是否在同一调用内修好,只把真正的失误计入。这次重排后国产开源模型包揽开源前 8。Arena 同时给出成本-性能帕累托图:MiMo-V2.6-Pro 每任务中位成本约 0.11 美元,MiMo-V2.6 Flash 约 0.05 美元(+2.53%),两者都落在帕累托前沿上;对比全榜第一档的 Claude Opus 5.5(Max)每任务约 5 美元、净提升约 +17%,GPT-6.1 Sol(Max)约 +15%——闭源顶级与开源第一之间仍隔着一个明显档位,但价格差约 40–50 倍。
要打折的地方:MiMo-V2.6-Pro 是 9 月 21 日发布的老模型,这次是榜单方法更新带来的名次变化,并非新模型;+3.8% 的误差条与第 2–4 名有重叠,名次稳定性要再看几周数据。另外 Meta 816B 的 Muse Spark Open 当天刚接入 Agent Arena,分数「即将公布」,开源第一的位子很快可能被挑战。实际用法上,开发者最常见的是把它接进 Claude Code / Cursor 一类 agent 工具作为便宜的主力或子代理模型(MiMo API 同时兼容 OpenAI 与 Anthropic 协议,改 base_url 即可),以及用 Batch API 跑大批量离线任务。
谁能用:① 权重:MiMo-V2.6-Pro-RL(1.02T 总参 / 42B 激活 MoE,1M 上下文,文本/图像/视频/音频输入)以 MIT 许可在 Hugging Face 和 ModelScope 开放下载,可商用,但自托管需要多卡集群。② API:小米 MiMo 开放平台按量付费,模型名 mimo-v2.6-pro,海外价每百万 token 输入 0.435 美元、输出 0.87 美元(缓存命中 0.0036 美元),国内价 ¥3/¥6,Batch API 再打五折;另有 UltraSpeed 超高速模式(最高约 20 倍推理速度,单独计价)。③ 其他入口:OpenRouter、MiMo AI Studio 网页、MiMo Code 与 MiMo 桌面客户端(会员订阅即可用 Pro/Flash,也可填自己的 API Key)。没有等候名单。
解读:Agent Arena 这类「真实任务+用户确认」的榜单,正在取代单一跑分成为 agent 选型依据;而它一改评分口径,开源榜就整体洗牌——说明评测方法本身已经是竞争变量。对开发者更实际的信号是帕累托图:0.1 美元级的开源模型已经能在真实 agent 任务上稳定为正,闭源顶级的溢价需要用「复杂任务成功率」来证明。讨论:1. 当榜单方法一改名次就大变,团队应该信 Arena 排名,还是坚持自建内部评测集?2. 每任务 0.11 美元 vs 5 美元,你的 agent 工作流里有多少步骤其实可以交给开源模型?原帖:https://x.com/arena/status/2110815995950731340 ;榜单:https://arena.ai/leaderboard/agent ;权重:https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL ;官方定价:https://mimo.mi.com/models/en-US/mimo-v2.6-pro