整理:TopAIMap 编辑
Vera Rubin 首份第三方智能体推理成绩:每兆瓦吞吐最高达 GB300 的 5.7 倍,DeepSeek V4.1 Flash 跑到 906 tok/s
10 月 15 日约 6:18pm(PT),Artificial Analysis 公布 NVIDIA Vera Rubin NVL72(72 颗 Rubin GPU + 36 颗 Vera CPU 的机架级系统)在 AA-AgentPerf 智能体编程推理基准上的首批结果:在同等用户速度下,每兆瓦 GPU 功耗的总吞吐最高是上一代 GB300 NVL72 的约 5.7 倍(DeepSeek V4 Pro,约 190 tok/s/用户),DeepSeek V4.1 Flash 约 5.4 倍、GLM-5.2 约 3.0 倍、Kimi K3 约 2.8 倍;DeepSeek V4.1 Flash 单用户最高 906 tok/s,是该榜所有模型最快纪录。
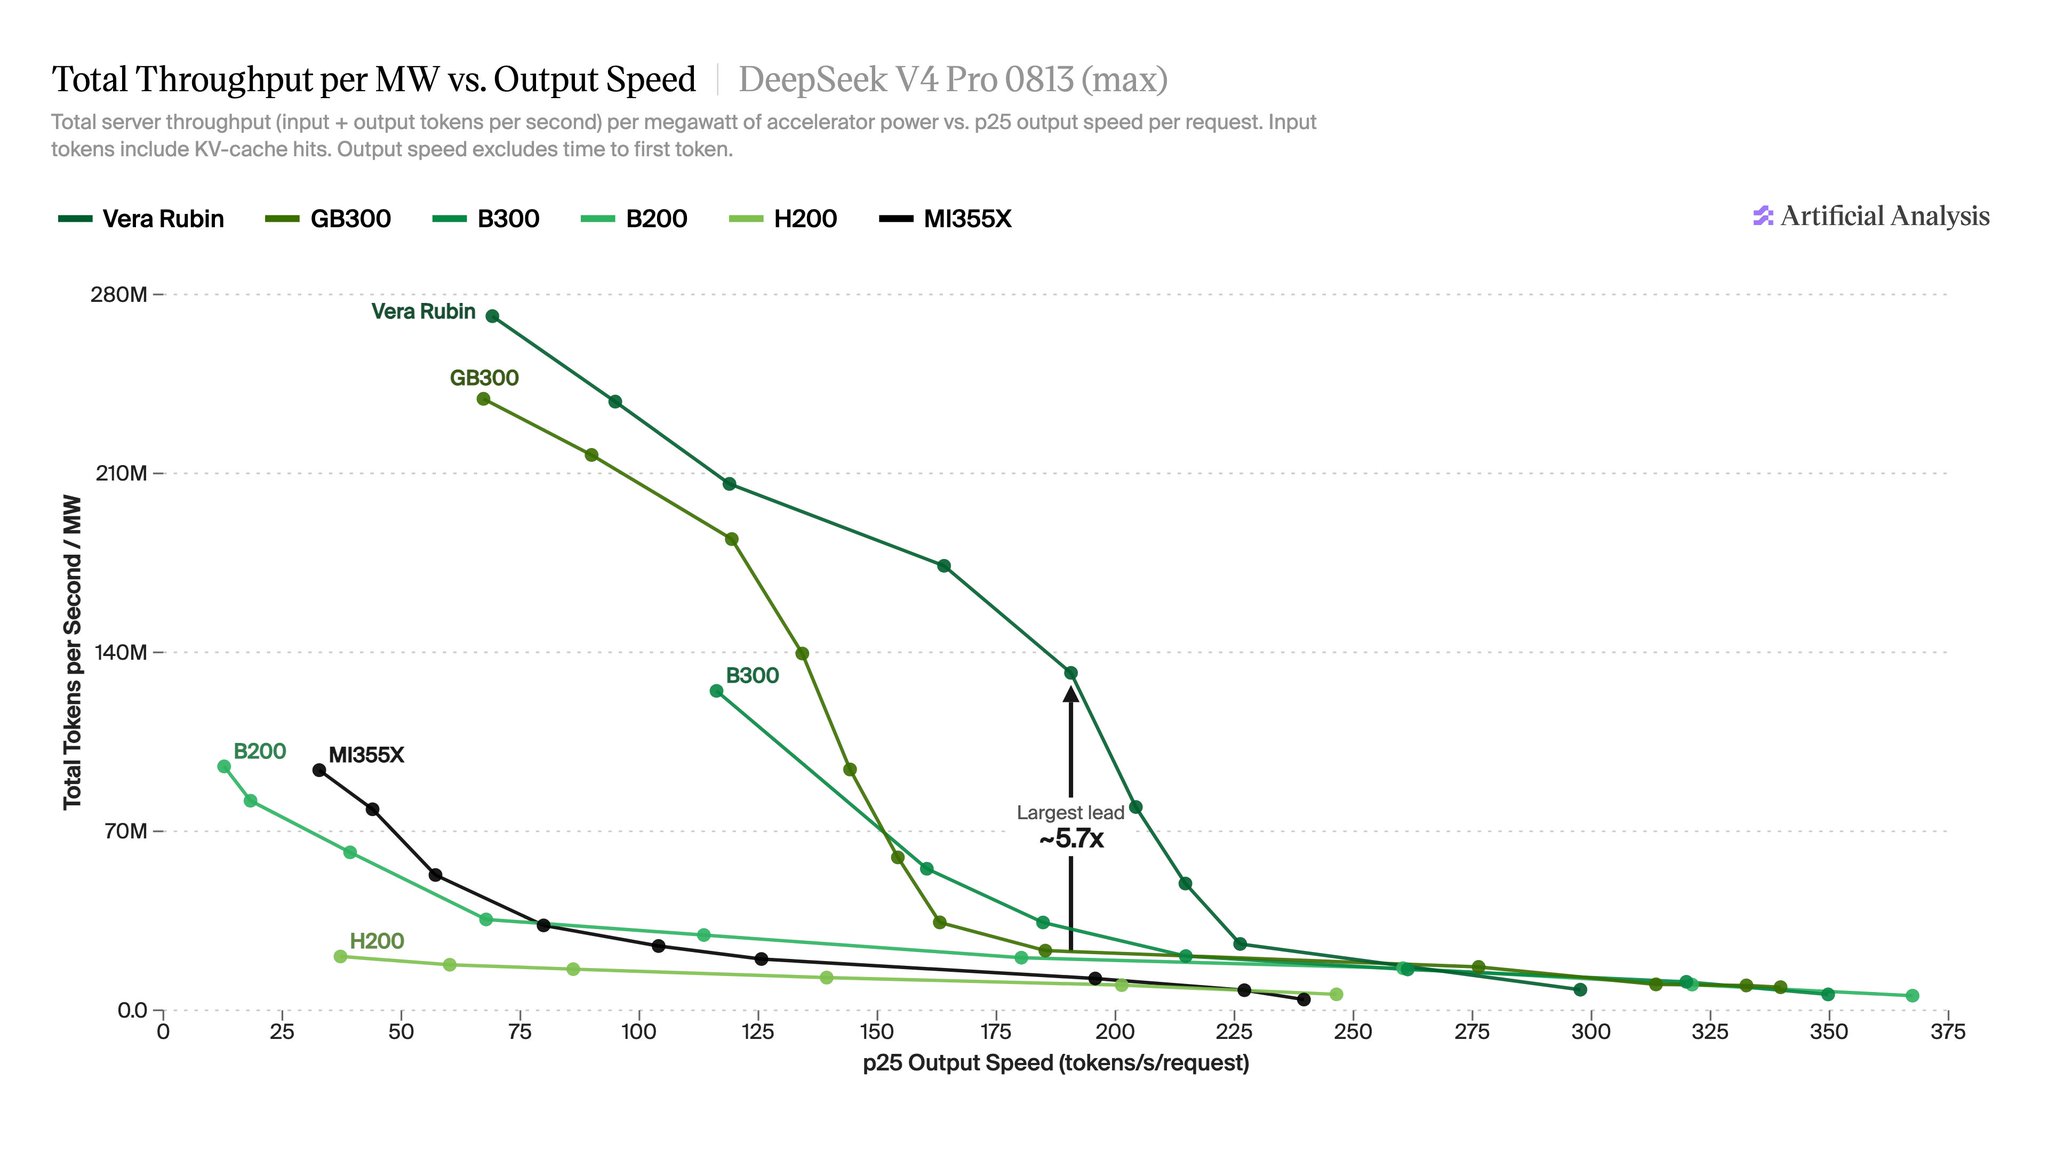
成绩要分两档看:拉满吞吐时差距没那么大——DeepSeek V4 Pro 每兆瓦 2.72 亿 tok/s 对 GB300 的 2.39 亿(1.14 倍),V4.1 Flash 5.71 亿对 3.95 亿(1.45 倍),GLM-5.2 1.35 倍,Kimi K3 1.26 倍;真正拉开的是「又快又多」区间:DeepSeek V4 Pro 从约 120 提到约 165 tok/s/用户,GB300 要掉 81% 吞吐,Vera Rubin 只掉 16%。硬件上单颗 Rubin 仍是 288GB 显存,但 HBM4 带宽 19.2TB/s(2.4 倍)、NVLink 6 达 3.0TB/s、稠密 NVFP4 35 PFLOPS(2.3 倍),Vera CPU 把 C2C 带宽翻倍到 1.8TB/s,用来把 KV cache 卸到 CPU 内存。AA-AgentPerf 回放的是真实编程智能体会话:单请求最长 132K 输入、平均 97% 输入与上一轮重复、中间有工具调用停顿,比固定长度 prompt 更接近 Claude Code / Codex 这类日常工作流。
需要打折的地方:所有 Vera Rubin 结果由 NVIDIA 自己提交(TensorRT-LLM / vLLM + Dynamo、NVFP4 权重、DSpark 投机解码),V4.1 Flash 的回复被截到 2048 token(其他提交为 16384),AA 也承认略有利于 Vera Rubin;Vera Rubin 首 token 更慢(约 165 tok/s 档中位 1.65 秒 vs GB300 1.08 秒),按含首 token 的端到端速度算,DeepSeek V4 Pro 上 GB300 在多数区间能打平甚至反超。AMD MI355X、H200、B200 等也在同一张图里,但远落后于这两代机架。
谁能用:Vera Rubin NVL72 是数据中心整机柜系统,普通用户和个人开发者买不到也租不到单卡;目前通过 NVIDIA 与 OEM/云厂商渠道供货(Supermicro 本周在 OCP 全球峰会展示了整机柜),本次报告没有给出云上按小时价格或开放时间。能马上用的是结果本身:AA-AgentPerf 榜单和每个点背后的服务配置浏览器免费公开,团队可直接照搬调优配置;被测的 DeepSeek V4 Pro / V4.1 Flash、GLM-5.2、Kimi K3 都是开放权重模型,也可通过各家官方 API 或 OpenRouter 等第三方托管调用。
解读:大厂买卡越来越受电力而不是卡数限制,「每兆瓦能服务多少智能体」才是下一代算力的真实 KPI。5.7 倍这个数字来自 GB300 吞吐「掉下悬崖」的高速区间,峰值时只领先 1.1–1.5 倍——对要做低延迟编程助手的厂商是巨大红利,对只拼批量便宜 token 的推理商则没那么夸张。另一个信号是:NVIDIA 选来展示新架构的四个模型全是中国开放权重模型,说明它们已经成为推理基础设施的事实标准负载。讨论:1. 如果你在做编程智能体产品,会为 165+ tok/s 的单用户速度付溢价吗?2. NVIDIA 自提交、自调优的成绩,要等多少家云厂商复现才算数?原文:https://artificialanalysis.ai/articles/vera-rubin-nvl72-agentperf ;AA 帖:https://x.com/ArtificialAnlys/status/2110903253013762365