整理:TopAIMap 编辑
Datadog 发布首个自研模型 Scout 1.0:基于 GLM-5.3 Flash 做强化学习,排障质量追平 GPT-6.1 Sol、Opus 5.5,推理成本低 3–8 倍
10 月 15 日,Datadog AI Research 发布 Scout 1.0,这是 Datadog 第一个专门用于排查线上故障的 AI 模型,驱动其 AI SRE 智能体 Bits Investigation。在内部基准 AlertEval 上,Scout 1.0 medium 的排障质量与 GPT-6.1 Sol high、Claude Opus 5.5 high 相当,估算推理成本低 3–8 倍;与 Fable 5.1 medium、GPT-6 Astra medium 表现相近,成本分别低 12 倍和 19 倍;加大测试时算力后,Scout 1.0 xhigh 追平 Fable 5.1 xhigh,成本低 4 倍。
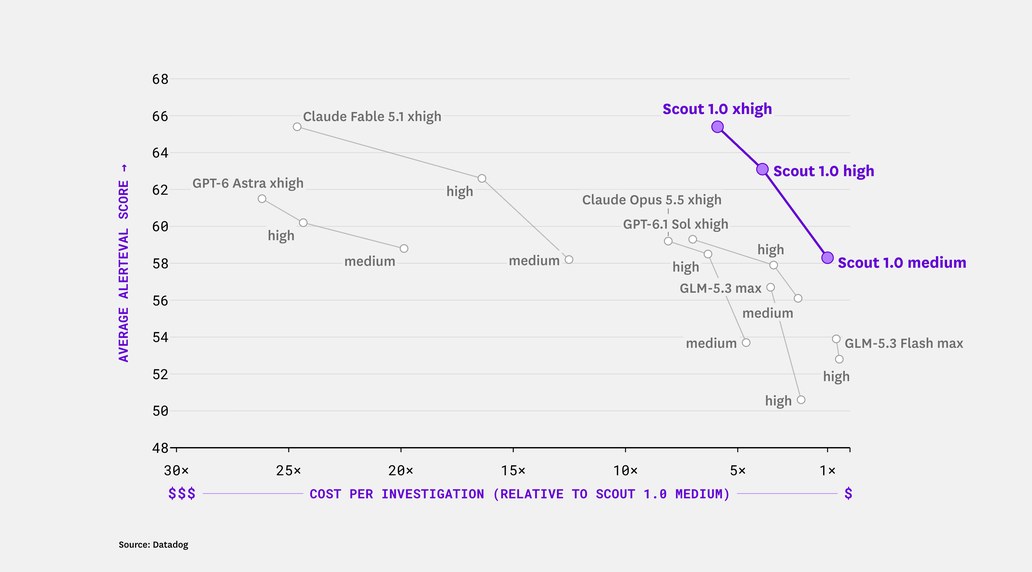
怎么练出来的:Scout 以智谱开源的 GLM-5.3 Flash 为底座,在排障模拟环境里用强化学习做后训练。模拟环境用真实历史事故和真实告警的遥测数据搭建,已知根因,Datadog 称训练数据不含客户数据;模型练习使用的工具与 Bits Investigation 线上工具同名、同参数、同返回格式,奖励「找到根因并用证据支撑结论」。RL 框架为自研异步栈,基于 SkyRL 和 Ray 的分支。评测上,AlertEval 由真实告警、存档遥测和 Datadog 工程师写的根因说明组成(0–100 分,按与专家结论的吻合度给部分分,不等于「解决了多少比例的事故」);在第三方基准 SREGym(90 个故障)上,Scout 1.0 medium 明显强于底座 GLM-5.3 Flash,并以不到四分之一的成本超过 GLM-5.3,高档位与前沿模型相当,成本仍至少低 2 倍(比 Astra/Fable 级模型低 10 倍)。
真实用法:技术报告给了一个 Datadog 内部真实事故:Postgres 的 30 个 autovacuum 工作进程全部忙了一个多小时,死行从 30 万涨到 450 万;真正的起因是两小时前的一次 Kubernetes 节点排空——只读副本连同本地盘被删,新副本在另一节点空盘启动,主库仍保留旧的复制槽,导致清理进度卡住,从根因到告警隔了 5 跳。Scout 排除了写入高峰的假设,发现替换副本未就绪、反复请求已不存在的复制日志,最终把告警追溯到那次节点排空。Datadog 的思路是:单次排查要反复调模型,成本降下来,就能对更多告警、在事故更早阶段自动排查,难题再用 xhigh 多花算力。
谁能用:Scout 目前是封闭预览,只在 Bits Investigation(Datadog 的 AI SRE)里使用;Datadog 自家工程团队和一小批预览客户已在生产告警上使用,其他客户可在 Datadog 产品预览页报名。Datadog 未公布 Scout 的单独 API、开源权重或定价,正式发布(GA)时间也未公布。
解读:这是「垂直场景小模型 + 专有工具环境 RL」路线的又一个样本:用开源中等模型做底座,靠自家工具链和真实事故数据造训练场,在单一任务上做到前沿模型水准、成本降一个数量级。对 Datadog 这类平台来说,护城河不在模型本身,而在只有它拥有的遥测数据和工具接口;同时,又一家美国大公司选择中国开源模型(GLM-5.3 Flash)当底座,也值得注意。但 AlertEval 是 Datadog 自建、自评(LLM 当裁判)的基准,独立复现还要看 SREGym 之外的更多第三方结果。讨论:1. 你会让一个专用小模型做线上事故的第一响应人,还是只信前沿通用模型?2. 掌握数据和工具环境的 SaaS 公司,自训模型会不会成为下一波标配?
参考资料