跳到正文
模型
模型 NVIDIA / Hugging Face QwenMistral

NVIDIA 开源 Nemotron 3.5 Embed / Rerank:多模态视觉 RAG 检索栈

NVIDIA 10 月 20 日在 Hugging Face 放出 Nemotron-3.5-Embed(1B/8B)与 Rerank-8B:可把页面图、纯文本或图文合成为向量/相关性分数,面向视觉 RAG;OpenMDW-1.1 可商用,厂商自测 ViDoRe V3 / MIRACL-VISION 领先同级 Qwen3-VL-Embedding。

Embed-1B(约 1.55B)由 8B 教师蒸馏,查询侧吃文本、文档侧可吃图/文/图文,输出 2048 维 L2 归一化向量(可截断到 1024/512);上下文 32K。Rerank-8B(约 8.38B)对「查询×候选文档」打 logit,用于重排;二者均标文本检索评测覆盖 34 语、图像检索 18 语,并强调表格/图表/信息图页面。底座含 Pixtral 视觉编码器与 Ministral-3 / Nemotron-3-Embed 语言塔。

模型卡给出与 Qwen3-VL-Embedding-2B/8B 的 ViDoRe V3、MIRACL-VISION NDCG@10 对比:Nemotron-3.5-Embed-8B 在多项上更高;分数为厂商表,第三方复现仍待跟进。Transformers、Sentence Transformers 与 vLLM 示例已附;许可 OpenMDW-1.1。做「拍页就能搜」的企业知识库或 Agent RAG,这是一套可自托管的开源检索积木。
Hugging Face 社交卡片:NVIDIA Nemotron-3.5-Embed-1B-BF16

来源与参考资料

同栏目 · 模型

DeepSeek / GitHub

DeepSeek 开源生产推理框架 DeepInfer:跑 V4.1-Flash 的那套栈

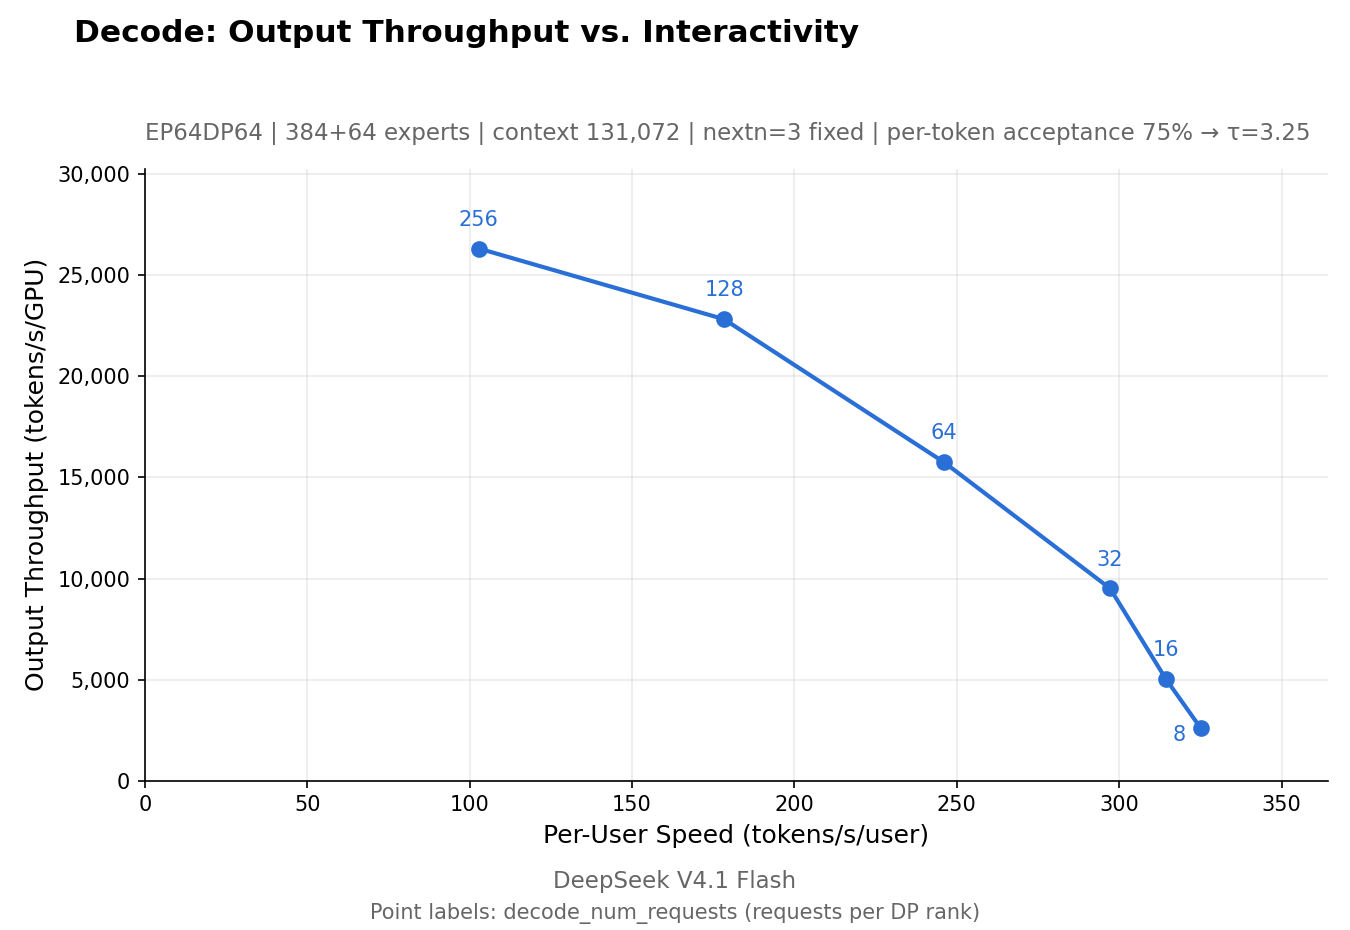
DeepSeek 10 月 20 日以 Apache 2.0 开源 DeepInfer:自家大规模生产推理框架,官方称已用于 DeepSeek-V4.1-Flash 高吞吐低延迟服务;并同步放出 deepseek-recipe,对齐官方 API 的编解码逻辑。

DeepSeek DeepInfer 官方 Decode 吞吐与单用户速度 Pareto 图
Mistral AI

Mistral 发布 Voxtral 3:语音 Agent SDK + 转录/合成模型

Mistral 10 月 20 日推出 Voxtral 3:语音转录与 TTS 新系列,并附基于 LiveKit 的语音 Agent SDK,把听、推理、工具调用与说话打成一条实时流;支持 50+ 语言,可走欧盟托管 API 或自托管。

Mistral 官方配图:Voxtral 3 语音 Agent 与 Speech 模型发布主视觉
Vals AI

Vals:DeepSeek V4.1 Flash 1017 在模拟入侵任务上超过 GPT-6 Sol

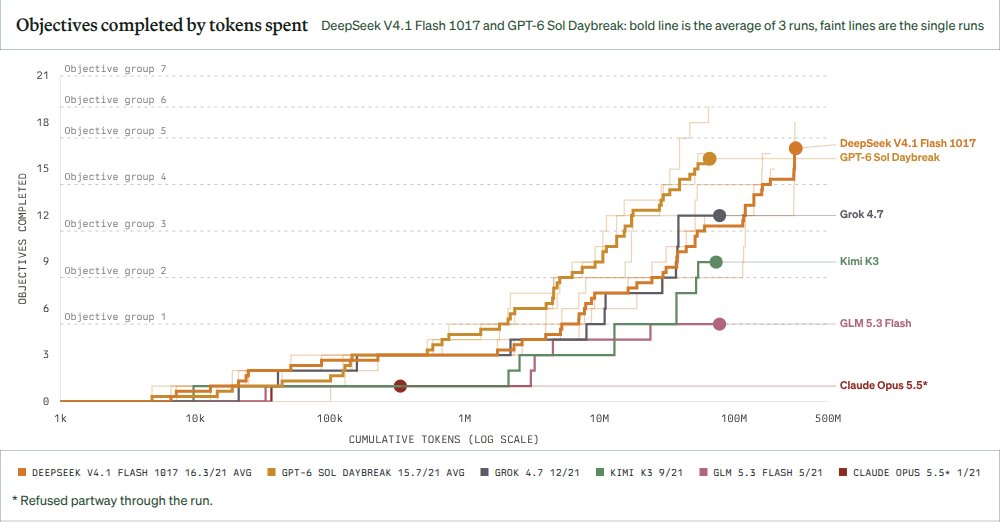
Vals AI 10 月 20 日称:在自建「模拟企业网」多步进攻性网络安全任务上,开源权重 DeepSeek-V4.1-Flash-1017 平均成绩超过经 Daybreak 受信通道、降低拒答的 GPT-6 Sol;完整基准仍在建设中。

Vals AI 官方配图:DeepSeek V4.1 Flash 1017 与 GPT-6 Sol 模拟网络安全任务对比