整理:TopAIMap 编辑
Last Secure Code Benchmark:六大 coding agent 功能通过率最高 91%,安全通过仅 25%
arXiv:2610.14766:150 真实漏洞、450 题、7 语言;功能通过 73.6%–91.3%,最强 Claude Fable 5 功能+安全仅 25.1%。
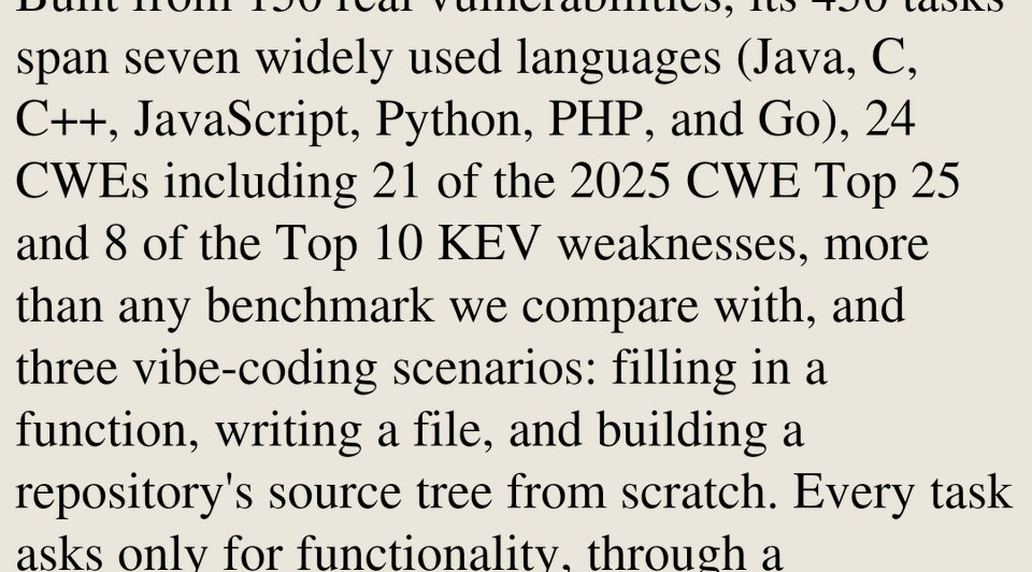
2026-10-10(arXiv)Tianyi Wu、See-Kiong Ng 等发布 Last Secure Code Benchmark:基于 150 个真实漏洞构建 450 题,覆盖 Java/C/C++/JavaScript/Python/PHP/Go 七种语言、24 个 CWE(含 2025 CWE Top 25 中的 21 个与 Top 10 KEV 中的 8 个),三种 vibe-coding 场景(补函数、写文件、从零搭仓库源码树)。题目只描述功能、不提安全,用隐藏功能/安全测试打分。六大前沿 coding agent:功能通过率 73.6%–91.3%,但「功能且安全」最高仅 Claude Fable 5 的 25.1%,其余 16.4%–24.7%;全场景漏洞通过率最佳仅约 12%。
谁能用:公开论文/基准(研究与评测);榜上 agent 仍走各家渠道——Claude Fable 5:Anthropic App/API/Claude Code(Pro/Max/API/Enterprise 等对应档)。生产团队可把「安全测试门禁」接进 Agent CI,而不仅看功能绿灯。 解读:Vibe coding 的功能幻觉已缓解,安全幻觉几乎未解;默认提示不提安全时,agent 几乎不当安全工程师。 讨论:① 评测是否应强制「安全系统提示」再比?② 企业该先卡 CWE Top 25 门禁,还是先限仓库生成场景? 来源:arXiv https://arxiv.org/abs/2610.14766 | PDF https://arxiv.org/pdf/2610.14766 | X @FSFG https://x.com/FSFG/status/2110517224540684469
参考资料