整理:TopAIMap 编辑
humanizer 登 HF 趋势榜:基于 Gemma 4 的 12B 本地「去 AI 腔」改写模型
jialinyyzz/humanizer 基于 google/gemma-4-12B,把英/中 AI 草稿改写成更像人写的邮件/论文/报告;HF 约 1542 赞、5.4 万下载,相关帖约 781 赞、3.7 万曝光。
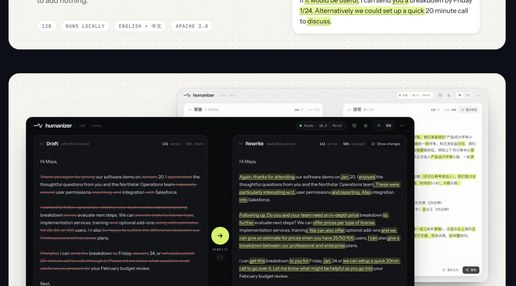
开源模型 humanizer(Hugging Face:jialinyyzz/humanizer)基于 Google Gemma 4 12B 微调,面向把 AI 生成的英文或中文草稿(邮件、论文、报告、论坛帖)改写成更自然的人类口吻,并强调保留数字、单位、日期、姓名与引语、不擅自添写。作者自测称:210 条英文改写中约 95% 在 Originality.ai 最严档被判为人类写作;420 条中 376 条无事实问题,仍建议发送前核对数字与专名。仓库提供 Mac/Windows 应用;最小约 2-bit 量化包约 3.9 GB,可在约 8 GB 内存机器上跑。许可 Apache-2.0。X @ivanfioravanti 帖称其为 HF 趋势榜第 2,约 781 赞、3.7 万曝光。模型页:https://huggingface.co/jialinyyzz/humanizer
谁能用:完全免费开源(Apache-2.0),个人/团队可本地下载 GGUF/safetensors 或桌面应用使用;无强制订阅。不绑定 Claude/GPT 等闭源 App 档位;推理发生在本地,隐私更可控。注意:改写工具可能被滥用于规避检测,使用应遵守平台与学术规范。 解读:把「去 AI 腔」做成可下载 12B 模型,说明风格对齐已从提示词技巧变成独立产品形态。讨论:① 检测器与 humanizer 会不会陷入军备竞赛?② 企业写作流更该用云端改写 API 还是本地 Gemma 微调?