整理:TopAIMap 编辑
Cheng Lou 开源 Handwired:普通 JS 编译成可微分神经网络,浏览器零训练运行
前 React/Midjourney 工程师 Cheng Lou 发布 Handwired:把常规 JavaScript 转成 ReLU 数值电路,输出与原程序一致且可梯度优化,浏览器无 GPU 可跑。
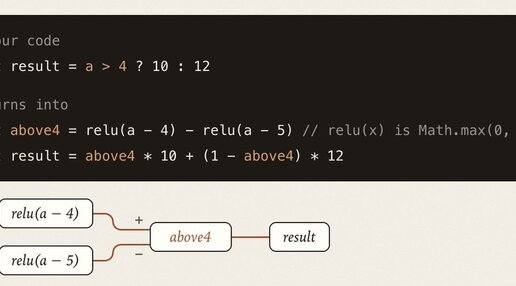
10 月 15 日凌晨(UTC),前 React / Messenger / ReasonML、现 Midjourney 工程师 Cheng Lou(@_chenglou)开源玩具项目 Handwired:把普通 JavaScript 编译成神经网络权重。声明无需训练、输出与原 JS 程序完全一致、全程可微分(ReLU 数值电路),并在浏览器内运行、不依赖 GPU。官方示例把 a>4?10:12 展开为 relu(a-4)-relu(a-5) 的加权混合;演示含约 9,909 权重 / 130 层的迷你桌面 OS、可解冻权重实时训练的画廊,以及把正则/JSON 解析转成 WebGPU 内核检索 10 万文档。仓库 github.com/chenglou/handwired 当日新建,主页 chenglou.me/handwired;发布帖约 889 赞 / 3.4 万曝光。
谁能用:开源项目,浏览器/本地免费试玩;可把编译后的「神经程序」挂到 nanoGPT 一类模型旁,让 LLM 同时「会说莎士比亚 + 会跑那段 JS」。影响:把控制流写进权重,模糊代码与网络的边界,适合交互原型与可训练 UI,但大规模 AST→稠密矩阵的显存压力仍是玩具级约束。 解读:Handwired 不是新 frontier 模型,而是把「程序=电路」做成可玩 demo——对做 agent/UI 的人更有启发:规则逻辑能否和可学习权重同一套表示。讨论:1. 这种可微分程序表示,会不会成为把业务规则注入 LLM 的新接口?2. 浏览器无 GPU 能跑通,生产级规模的瓶颈更可能是内存还是调试体验?
来源:Cheng Lou / X https://x.com/_chenglou/status/2110557373651931267 https://chenglou.me/handwired/ https://github.com/chenglou/handwired
参考资料