整理:TopAIMap 编辑
Apple ML Research 发布 RSI-Inference Bench:真实 vLLM/SGLang 上最佳智能体仅 26.7%
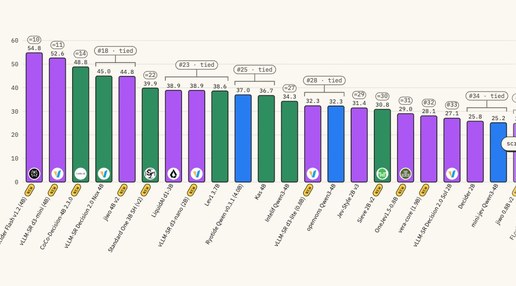
2026-10-16,Apple ML Research 开源 RSI-Inference Bench(37 题、最长约 8 小时),用真实 vLLM/SGLang 与 GPU 检验编码智能体能否做 Day-0 模型接入、推理优化与回归修复;官方称耗约 10 万美元 API token 与 5 万 GPU 小时,当前最佳智能体 pass@1 仅 26.7%。项目负责人 Ruixiang Zhang(@onloglogn)发帖约 60 赞、2500 展示。
当地时间 2026年10月16日(约中午 PT),Apple ML Research 开源 RSI-Inference Bench(仓库 apple-aiml-research/ml-rsi-inference-bench),面向「编码智能体能否改进跑大模型的推理栈」这一长程问题。项目负责人 Ruixiang Zhang(@onloglogn)与 Junteng Liu、Richard He Bai、Huangjie Zheng、Yizhe Zhang 等发布说明:基准从真实 vLLM / SGLang 工程任务抽出 37 题,覆盖 Day-0 新模型接入(10 题,pass/fail)、上线后推理优化(20 题,测加速比)与回归修复(7 题);智能体在钉住的引擎提交上离线工作最长约 8 小时,另有 verifier 编译、起服并计量。官方称投入约 10 万美元 API token 与约 5 万 GPU 小时;当前未饱和,最佳智能体 pass@1 约 26.7%。@onloglogn 官帖约 60 赞、约 2500 展示、40+ 收藏;GitHub 星标仍个位数量级。
条件与影响:这是研究基准与示例代码(Apple Sample Code License),不是面向消费者的 App 功能,也不是新一代基础模型权重。硬件面覆盖 H100/B200 等;任务横跨张量并行、MoE、FP8/FP4、稀疏/线性注意力等推理栈层。论文标注「coming soon」。与站内已有一般 Agent 榜不同,本题直接改生产推理引擎并在真 GPU 上验收,难度刻意未饱和。星标与转发仍偏早期,跨源热度中等。
谁能用:仓库与 rsi-inference.com 排行榜页公开可访;研究者可用 Pier(兼容 Harbor)对本机/机群上的 agent+model 跑题并上报分数。不提供 ChatGPT/Claude 式消费级 App,也无单独「RSI API」售卖。日常推理工程仍用自有 vLLM/SGLang 集群或云 GPU;本基准用于评测「会改引擎的智能体」,不是给终端用户换模型。无候补名单;许可为 Apple Sample Code License,商用前需自行核对条款。
真实用法:Apple 团队与合作作者用真实推理排障/优化工单当题库,而不是人造玩具仓库;社区 co-author 已在讨论「为智能体设计 humbling 任务」比刷分更难。预期用法是实验室把 Claude Code / Codex / 自研 agent 接到 Pier 上跑 Day-0 与优化轨,用 pass@1 与几何平均加速比对比,而不是在手机 App 里一键「自改进推理」。
解读:把 RSI(递归自改进)从「模型改模型」拉到「智能体改推理系统」——更贴近机房里的真实瓶颈。讨论:1)当最佳智能体在真 vLLM/SGLang 上只有约四分之一通关时,Agent 叙事是否过度透支了「自动运维推理栈」?2)未饱和基准会不会成为下一阶段开源 agent 的硬门槛,还是先沦为实验室自嗨?
来源:@onloglogn https://x.com/onloglogn/status/2111170954944823685 · GitHub https://github.com/apple-aiml-research/ml-rsi-inference-bench · 排行榜 https://rsi-inference.com