整理:TopAIMap 编辑
小米开源 MiDashengLM-Spatial:7B 音频大模型能听出声音「从哪来」,STAR-Bench 空间推理 70.3 分超 Gemini-3.6-Flash 的 47.0
10 月 15 日(PT)凌晨,小米在 GitHub 和 Hugging Face 放出 MiDashengLM-Spatial,上午 8:00 由 @XiaomiTech_ 正式官宣(当晚约 4.2K 浏览、104 赞)。这是在 MiDashengLM-7B 基础上加了一路「空间编码器」的音频语言模型,小米称是首个开源的端到端统一模型,既能听懂声音内容,也能判断声源方位与空间分布:STAR-Bench 空间推理 70.3 分(Gemini-3.6-Flash 47.0、Qwen3-Omni-30B 44.7、人类 73.7),MMAU-Pro 空间子集 55.4 分(Gemini-3.6-Flash 48.3);左右声道对调测试正确率 72.6%,其余对比模型大多为 0。权重与推理、评测代码均为 Apache 2.0,可商用。
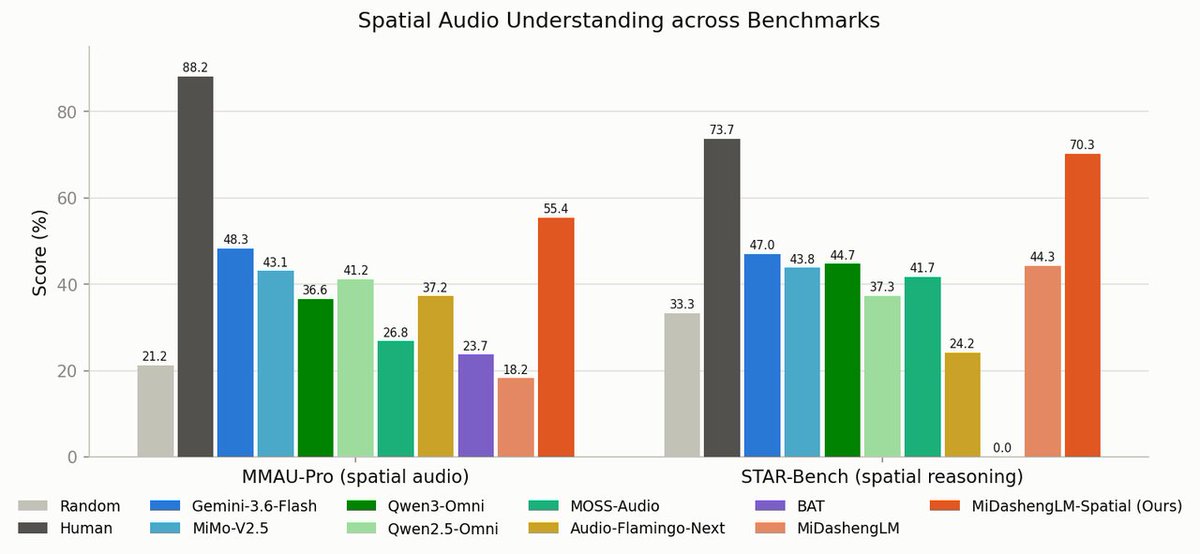
技术上它是「双耳」架构:原有的 Dasheng 语义编码器只吃单声道,新增的 Spatial-Dasheng 吃左右双声道,负责逐帧检测并定位重叠声源,两路通过分层「语义→空间」条件模块(HSSC)融合后交给 LLM(LoRA 微调)。训练数据靠合成:约 100 万个空间声学场景、约 1.3 万小时,覆盖环境声、人声和音乐,配 600 万条经过事实校验的问答。官方示例输出是「有人在听者左后上方打鼾」这种带方位的描述;单声道通用能力基本保住——MMAU-Pro 全集 56.4(底座 55.9),LibriSpeech test-clean WER 从 3.6 降到 1.8,东南亚语种 ASR 小幅领先同级开源模型。
要打折的地方:所有成绩都是小米自测(arXiv 2610.11156);MMAU-Pro 全集上 Gemini-3.6-Flash 仍以 70.4 对 56.4 明显领先,通用音频理解没有反超闭源;空间能力必须喂真实双耳 (2, T) 音频,单声道能跑但「没有方向」;空间训练数据以合成为主,真实环境泛化要看社区复测。目前小米没有公布哪款产品会用上,比较自然的落地方向是车舱(判断哪个座位在说话、救护车从哪侧来)、智能音箱/家居、AR 眼镜与助听设备、机器人和安防监听,这些都还属于推测场景。
谁能用:个人开发者和企业都能免费用——权重在 Hugging Face(mispeech/midashenglm-spatial,transformers + trust_remote_code 加载)和 ModelScope,推理示例与 STAR-Bench / MMAU-Pro 一键评测脚本在 GitHub,Apache 2.0 允许研究和商用;约 8B 参数,按 bf16 估算单张 24GB 显卡即可推理。没有官方托管 API、App 或付费档位,也没有等候名单;小米 MiMo 等 App 是否接入未公布。在线 Demo 页可直接试听样例。
解读:多模态大模型这两年把「看图」卷到了极致,「听」却还停在单声道转文字加分类——绝大多数音频模型分不清声音从左还是从右来,声道对调测试几乎全是 0 分就是证据。小米这一步的意义不在 7B 的分数,而在把「空间听觉」变成可直接 fine-tune 的开源底座,这对手里有车、有音箱、有眼镜的硬件厂商比对纯软件公司更有价值,也是小米生态自己最需要的能力。讨论:1. 车载和智能家居里,「听出方位」会比「听懂内容」更早变成刚需吗?2. 靠 100 万个合成场景训出来的空间感,放到真实嘈杂的客厅和马路上还能剩多少?原帖:https://x.com/XiaomiTech_/status/2110747532804436083 ;GitHub:https://github.com/xiaomi-research/midashenglm-spatial ;模型:https://huggingface.co/mispeech/midashenglm-spatial ;论文:https://arxiv.org/abs/2610.11156