整理:TopAIMap 编辑
Vals AI 发布 Robo-bench:GPT-6.1 Sol 仿真控臂/人形榜首 28.33%
Vals 用实时 MuJoCo 测前沿模型直控机械臂与人形:仅有相机与电机指令;Sol 总榜 28.33%,臂任务均 51/100,人形全员 <2/100。
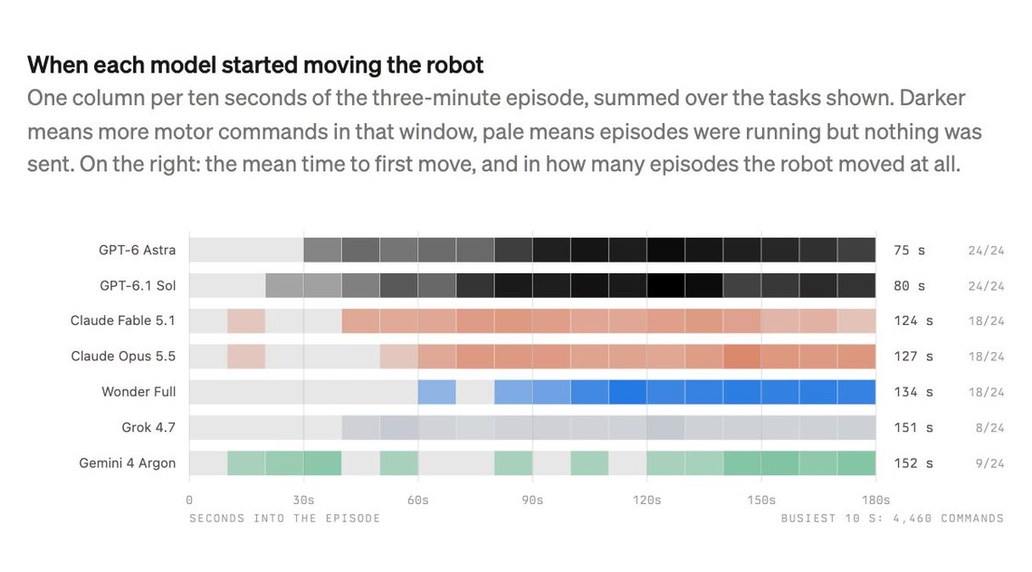
Vals AI 于 2026-10-14(约 22:55 UTC / 3:55pm PT)在 X 公布 Robo-bench(页面标注 Updated 10/13):把前沿语言模型放进各家 coding agent(Codex / Claude Code / Antigravity / Grok Build / Muse Code),在实时 MuJoCo 中控制 7-DoF Franka 臂与 29-DoF Unitree G1 人形,仅接收相机与传感器、输出电机指令,共 24 项任务(13 臂 + 11 人形,多数私有防刷榜)。官方榜:GPT-6.1 Sol 28.33%(估 API 成本约 $4.97)、GPT-6 Astra 23.33%(约 $28.48)、Claude Opus 5.5 14.58%、Wonder Full 10.42%、Claude Fable 5.1 5.83%、Gemini 4 Argon 0.83%、Grok 4.7 0.21%。臂侧 Sol 均约 51/100 并解出 4 题;人形侧无一模型均分超过 2/100。仿真从启动起实时计时,思考即耗时:Sol/Astra 平均约 75–80 秒发出首条电机指令且每局都动臂;Argon 与 Grok 4.7 多数局从未移动。与同日 AA-Robotics(真机六轴+编码 harness)形成互补:此处强调仿真低层电机控制与人形平衡。
谁能用:Robo-bench 为公开榜单/方法论文档(非消费级新产品)。榜上模型仍走各自渠道——GPT-6.1 Sol / GPT-6 Astra:OpenAI API 及 ChatGPT/Codex 对应档;Claude Opus 5.5 / Fable 5.1:Anthropic App/API/Claude Code(Free/Pro/Max/API/Enterprise);Gemini 4 Argon:Gemini App(AI Pro/Ultra)、付费 API、Antigravity;Wonder Full:Meta Muse Code 更高订阅档;Grok 4.7:xAI/Grok 对应产品。本地复现需自备 harness 与仿真环境。 解读:语言 Agent「写控制器」已能部分搞定仿真臂,但人形平衡/行走仍接近零分;实时时钟把「慢思考」变成硬失败。讨论:① 下一阶段该优先压首令延迟,还是专训人形 loco-manipulation?② 真机 AA-Robotics 与仿真 Robo-bench,哪套更接近产线验收? 来源:Vals AI · X @ValsAI https://www.vals.ai/benchmarks/robo_bench https://x.com/ValsAI/status/2110504836521496812
参考资料