整理:TopAIMap 编辑
Tether 开源端侧语音识别 QVAC TranscribePsy:254M 参数、25 种欧洲语言,iPhone 17 Pro Max 上 10 分钟音频 1.65 秒转完
USDT 发行方 Tether 旗下 Tether AI Research 发布 QVAC TranscribePsy 系列语音识别模型,2.54 亿参数,可完全离线在手机、笔记本运行;权重 Apache-2.0,附 GGUF 与 Core ML 版本。
10 月 14 日早上(PT),Tether AI Research 官方账号 @qvac 发帖称「We just released QVAC TranscribePsy」,Tether CEO Paolo Ardoino 同步转发推介;两条帖合计约 2.7 万浏览,The Block、bitbank 等加密与科技媒体跟进报道。模型卡显示,TranscribePsy-250M 由 NVIDIA Parakeet-TDT-0.6B-v3(627M)经结构化剪枝加知识蒸馏得到,参数 2.54 亿,训练数据约 56.4 万小时。官方称在同量级(约 250M)模型中三项基准全部领先:Open ASR Leaderboard 词错率 8.02、Multilingual LibriSpeech 6.58、Common Voice 21.56,对比 Whisper-small 分别为 12.34 / 11.51 / 38.17;在 MLS 上还胜过体量三到四倍的 Qwen3-ASR-0.6B(12.60)和 Whisper-Medium(7.76)。
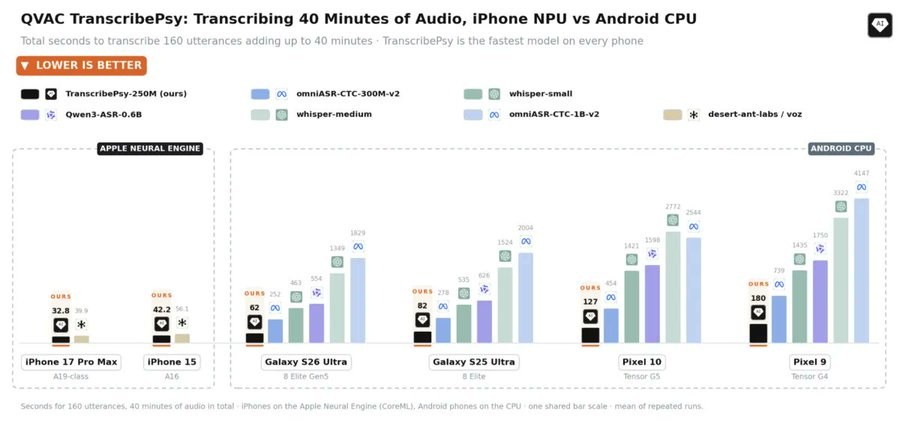
谁能用:权重以 Apache-2.0 开源,可在 Hugging Face qvac/TranscribePsy-250M-EU 系列下载,共四个版本——25 语言 PyTorch(NeMo)版、8 语言 EU-sub 版、手机 CPU 用的 8-bit GGUF 版(配套 qvac-fabric-speech.cpp 引擎)、Apple 神经引擎用的 Core ML 版;无订阅、无 API 门槛,面向自建 App 与端侧硬件开发者。注意语言范围:手机版只支持 8 种欧洲语言,25 语言版也不含中文、日文。官方测速:iPhone 17 Pro Max 用 Core ML 版转写 160 句、共 40 分钟音频约 32.8 秒,iPhone 15 约 42.2 秒,Galaxy S26 Ultra(CPU)约 62 秒;六款手机平均实时率 0.052、峰值内存 534MiB、冷启动 252ms。以上均为官方自测,完整技术报告尚未发布。
真实用法:官方定位是装进手机 App、智能眼镜和人形机器人里的离线听写,音频不出设备;社区开发者已在多语种群体里把手机端测速图拿来对比 Whisper-small 与 omniASR,并提醒「8 语言手机版不能顺手理解成支持中文」。对做会议纪要、外勤录音、欧洲多语客服的团队,它是一个可以直接塞进 iOS/Android 包体的 Whisper 替代候选。
解读:稳定币公司做 AI 模型听起来跨界,但 Tether 押的是「本地优先、数据不出端」的路线,这和它一贯讲的去中心化叙事一致;254M 体量把端侧 ASR 的门槛又压低一档,真正的看点是 GGUF + Core ML 双版本同时开源,省掉了开发者自己量化移植的那一步。短板也明显:中文、亚洲语言暂缺,且全部成绩来自自测。 讨论:1. 端侧小模型 ASR 会不会让 Whisper API 一类云端转写服务的价格继续下探?2. 非 AI 原生公司(如 Tether)做开源模型,是品牌营销还是长期生态投入?