整理:TopAIMap 编辑
Sword 发布心理健康模型 Dawn 1:基于 GLM-5.3 后训练,安全协议遵循 0.94 超 GPT-5.6 Sol,谄媚「夸大」降 75%
10 月 14–15 日,数字医疗公司 Sword Health 研究团队发布 Dawn 1:以智谱 GLM-5.3 为底座做多轮 RL 后训练,用于其全天候心理健康支持平台。官方称多轮安全协议遵循率从 0.76 升到 0.94,高于 GPT-5.6 Sol(0.87)与 Claude Opus 5(0.79),谄媚中的「夸大」下降 75%,且每千轮输出成本约为底座一半。
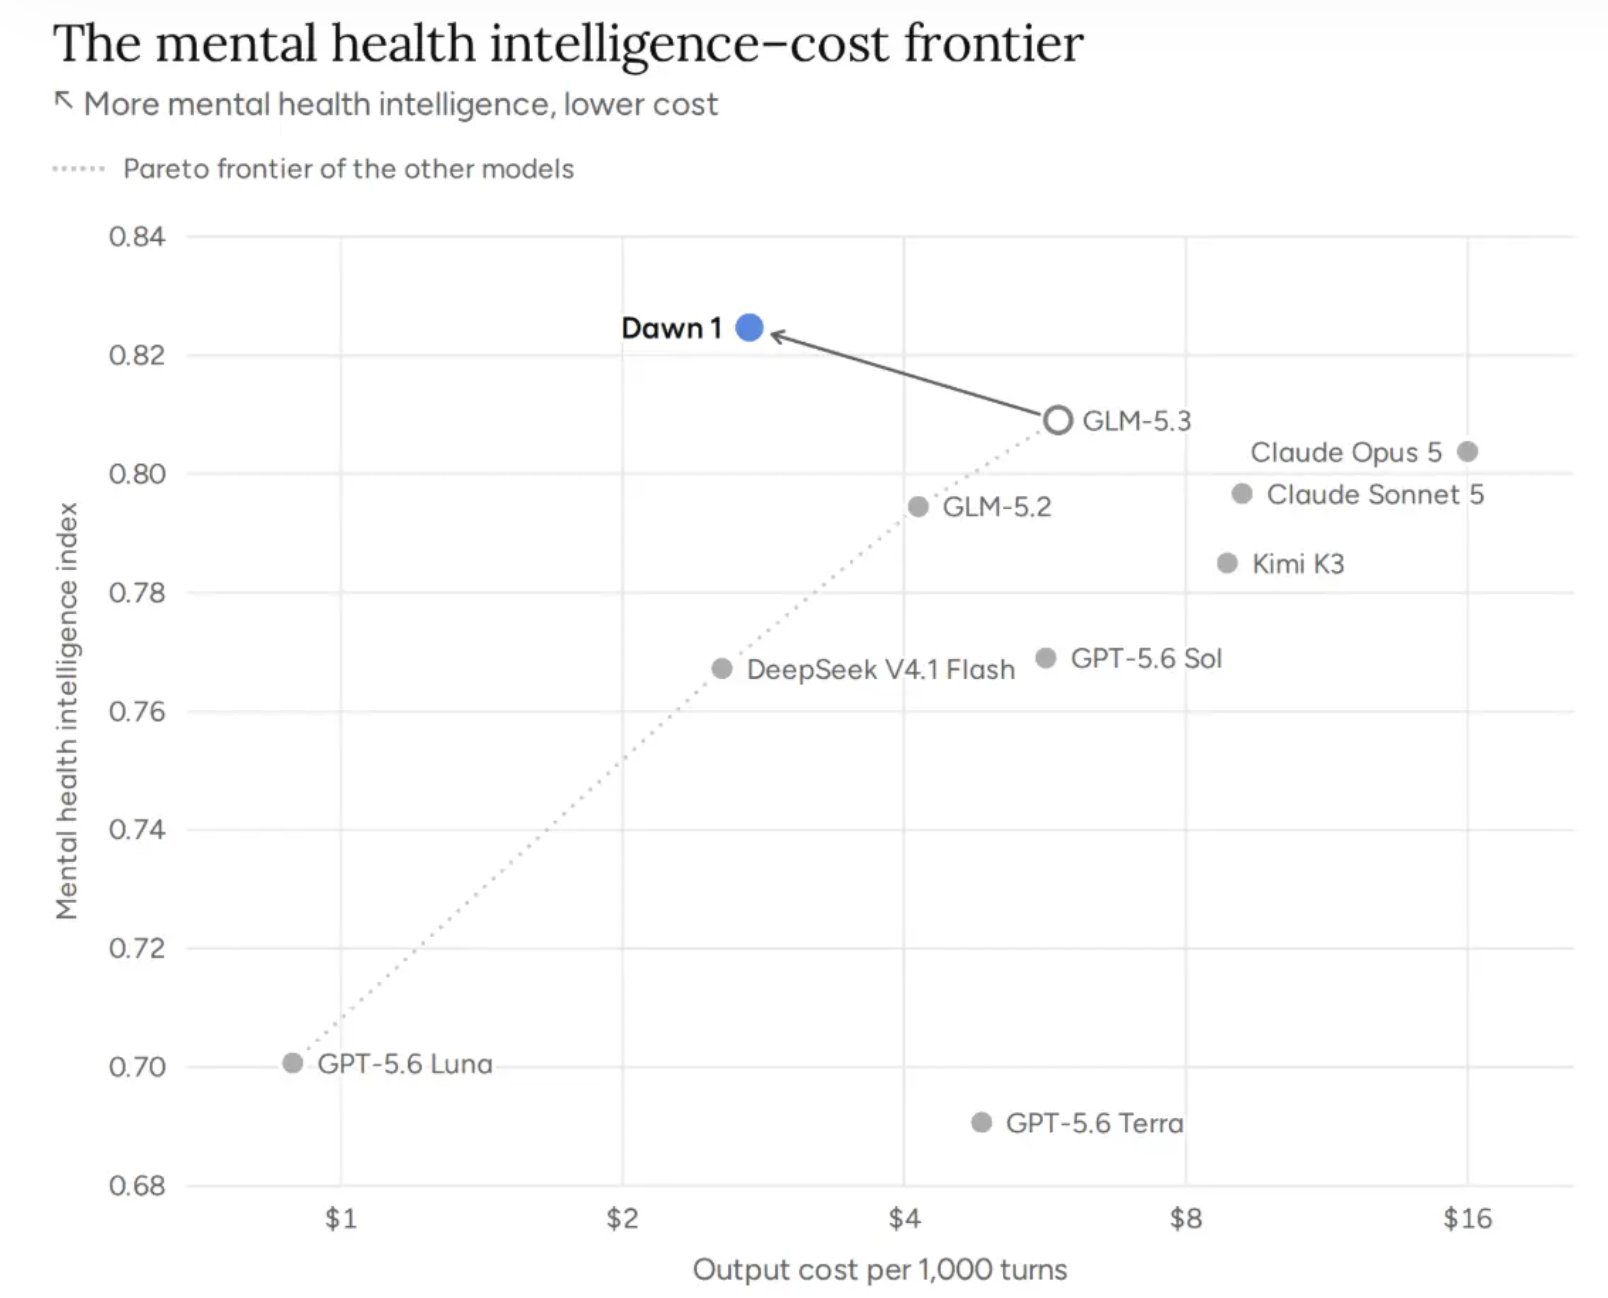
Sword Health(@SwordHQ)AI 研究负责人 Ricardo Rei 于 10 月 15 日在 X 发帖,并配合官网 10 月 14 日长文《Introducing Dawn 1》,公布团队成立一年来的首个自研模型 Dawn 1。它不是从零预训练,而是在开源底座 GLM-5.3 上做后训练,专门驱动 Sword 的 AI 心理健康支持:模型挂在自家 harness 上,会持续保存每位会员的记忆与临床画像、在合适时机主动联系,并在空闲期回顾对话做个性化调整。
关键数字(均为 Sword 自测口径):自建「心理健康智能指数」上,Dawn 1 约 0.82,高于 GLM-5.3(约 0.81)、Claude Opus 5(约 0.80)、Kimi K3、GPT-5.6 Sol 等,每千轮输出成本约 2–3 美元,仅为 GLM-5.3 的一半左右、Opus 5 的约 1/5;临床团队编写的高风险情境安全协议,在多轮 RL 环境中训练后遵循率 0.76→0.94,高于 GPT-5.6 Sol(0.87)、Claude Opus 5(0.79);在其追踪的所有谄媚类别都低于底座,其中「夸大」下降 75%。训练基于开源 Prime-RL 改造,跑在 64 张 NVIDIA B300 上,NCCL 通道亲和修复提速 11.7 倍、并行导出检查点 3.8 倍,累计提速 1.64 倍;评测数据来自匿名化的真实对话,并配合合成高风险场景与 Dawn Gym 仿真环境。
谁能用:Dawn 1 目前只用于 Sword 自家心理健康产品,面向通过雇主或医保计划接入的 Sword 会员;官方博客没有提到开放 API、开源权重或对外定价,普通开发者暂时用不上。安全层也不只靠模型本身,还叠加了团队 NeurIPS 论文 MindGuard 启发的分类器与临床人员复核。
解读:这是「开源底座 + 垂直 RL 后训练」路线在高风险医疗场景的一次样板:用真实脱敏数据与临床规则做多轮奖励,在安全遵循和抗谄媚上压过通用前沿模型,同时把成本砍半。它也说明 GLM-5.3 这类中国开源模型正成为海外垂直公司的默认底座。不过所有指标都是自建评测、尚无第三方复现,心理健康场景的「安全」最终要看真实干预结果而非 benchmark。 讨论:1. 心理健康这类高风险场景,垂直后训练模型是否应强制通过第三方安全评测才能上线?2. 海外医疗公司以中国开源模型为底座,会不会在合规与采购层面遇到新的阻力?