整理:TopAIMap 编辑
斯坦福 Hazy Research 开源 NCM:粗到细并行生成,下游任务最高约 31× 加速
Stanford Hazy Research 发布 Next-Concept Modeling(NCM):多尺度残差 VQ-VAE + 分层并行 Transformer;相对强扩散语言模型,摘要/翻译最高约 31× 更快,开源论文、代码与权重。
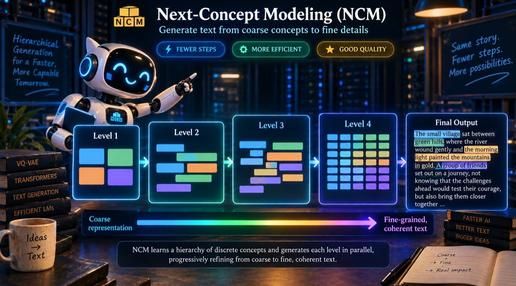
2026-10-14,斯坦福 AI Lab / Hazy Research 团队(Hermann Kumbong、Ishan Khare 等,指导 Simran Arora、Azalia Mirhoseini)发布 Next-Concept Modeling(NCM):先用多尺度残差 VQ-VAE 把文本编成层级离散码,再用 Transformer 按层生成、同层全并行,实现「粗概念→细细节」的生成。相对同规模强扩散语言模型(DLM):下游摘要/翻译最高约 31× 更快且质量可比或更好;无条件生成在 TinyStories/LM1B/OpenWebText 上约 10–21× 更快、训练 token 约少 3–5×;Sudoku 等推理亦优于 AR 与扩散基线。论文 arXiv:2610.14162;代码 github.com/HazyResearch/ncm;权重/数据在 Hugging Face hazyresearch/ncm;另有 Hazy Research 与 Scaling Intelligence 两篇博客。作者帖约 9.4 万曝光、370+ 赞;StanfordAILab 转发约 1.9k 曝光。
谁能用:研究/开源——论文、代码、checkpoints 与数据集公开(GitHub + Hugging Face),本地/自建推理;非消费级 App 订阅。属新生成范式,非替换 GPT/Claude/Gemini 现成 API。 解读:推理成本成为主矛盾后,「少步并行」路线开始与 AR/扩散三分天下;NCM 的残差层级是关键工程点。 讨论:① NCM 能否在百亿参数与长上下文上保持加速比?② 生产系统会先用它做翻译/摘要,还是先做推理任务? 来源:Stanford AI Lab https://x.com/StanfordAILab/status/2110517407395860570 | Hermann Kumbong https://x.com/KumbongHermann/status/2110437870481834432 | arXiv https://arxiv.org/abs/2610.14162 | GitHub https://github.com/HazyResearch/ncm | HF https://huggingface.co/collections/hazyresearch/ncm | Blog https://hazyresearch.stanford.edu/blog/2026-10-12-ncm