整理:TopAIMap 编辑
RoboQuest 机器人长程基准:Gemini 4 Argon 与 GPT-6 Astra 并列第一,成功率也只有约 24%
declare-lab 的 RoboQuest 让前沿模型直接操控移动机械臂找线索、做任务,每模型 500 局:Gemini 4 Argon 23.8%、GPT-6 Astra 23.2%,单局成本都约 11 美元;失败主因是不去找证据,而不是手不稳。
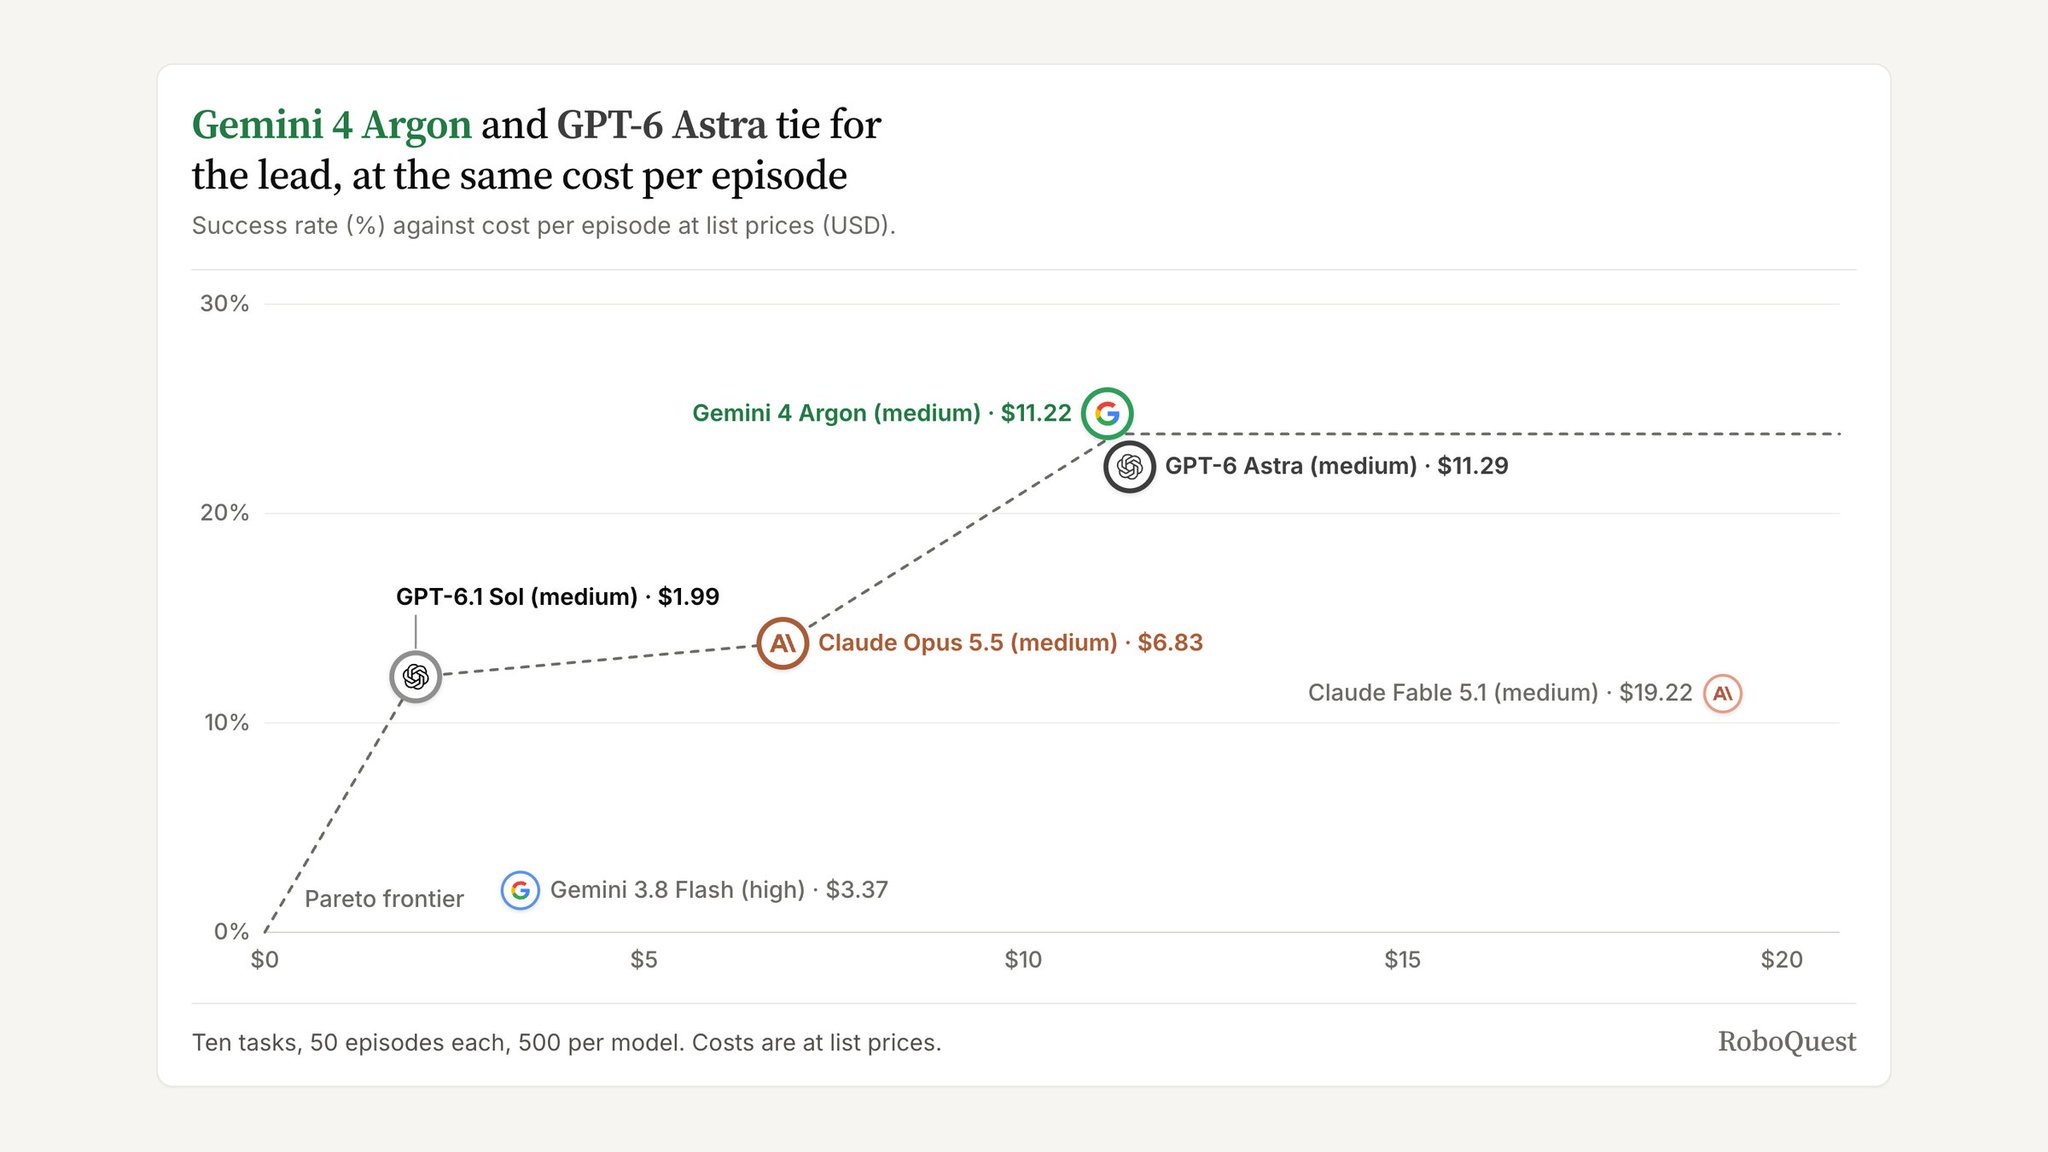
10 月 14 日晚(PT),Soujanya Poria 所在的 declare-lab 更新了机器人长程智能体基准 RoboQuest,把刚 GA 的 Gemini 4 Argon 加了进来。测试里,模型操控 MuJoCo 仿真中带移动底盘的 Franka 机械臂(RoboCasa365 场景),每轮看 3 张相机图和机器人状态,只能回一个工具调用(移动夹爪、移动底盘、等待或停止),最多 200 轮,没有抓取、找物之类的辅助函数,做完还得自己按场景里的红色 SUBMIT 按钮。任务所需信息一开始都是藏着的,比如东西在哪、杯子下面压着什么。10 个任务、每模型 500 局、不做微调的结果:Gemini 4 Argon 23.8%($11.22/局)、GPT-6 Astra 23.2%($11.29)、Claude Opus 5.5 13.8%($6.83)、GPT-6.1 Sol 12.2%($1.99)、Claude Fable 5.1 11.4%($19.22)、Gemini 3.8 Flash 2.0%($3.37);在团队演示数据上微调的 π0.5 几乎从不成功。
关键发现:如果提前把隐藏信息告诉模型,GPT-6 Astra、Claude Opus 5.5 和 GPT-6.1 Sol 完成单项技能的成功率有 72–81%,失败里只有 18–21% 是执行错误,66–74% 是该收集的证据没收集或没用对,常见情况是需要的东西就在模型看过 5 次以上的抽屉或箱子里,它却从没打开过;还有模型误以为做完了就按了提交。谁能用:基准是公开的,论文在 arXiv,代码在 GitHub,数据集在 Hugging Face,任何人都能复现;成本按各家 API 标价计算,被测模型都能通过各自 API 调用。
解读:这份榜单说明,前沿模型当机器人「大脑」时,短板已经不在动作控制,而在会不会主动探索、会不会判断任务真的完成了。Gemini 4 Argon 和 GPT-6 Astra 同分同价,GPT-6.1 Sol 只花不到 2 美元就拿到一半成绩,性价比曲线比榜首更值得看。另外样本仍是仿真加 10 个任务,离真机部署还有距离。 讨论:1. 让模型「多翻抽屉」该靠提示和工具设计,还是要专门训练探索能力?2. 你会为了多 10 个百分点的成功率,付 5 倍的单局成本吗?
来源:Soujanya Poria(X)https://x.com/soujanyaporia/status/2110612095381483561 ;论文 https://arxiv.org/abs/2610.10388 ;项目页 https://declare-lab.github.io/RoboQuest/ ;代码 https://github.com/declare-lab/RoboQuest ;数据 https://huggingface.co/datasets/declare-lab/RoboQuest