整理:TopAIMap 编辑
NVIDIA 开源 Nemotron 3.5 Super VL:120B MoE(激活 12B)视觉语言 Agent 模型,权重与配方同日上线 Hugging Face
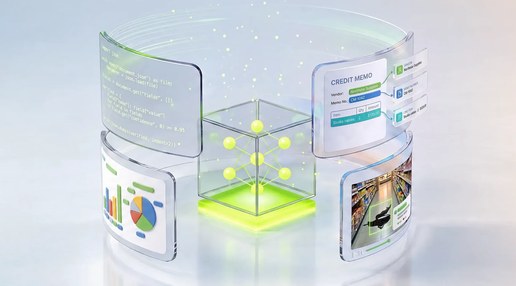
10 月 15 日,NVIDIA 正式发布开源多模态模型 Nemotron 3.5 Super VL:总参约 120B、激活约 12B 的混合 Mamba-2 + MoE + Attention 架构,搭配 C-RADIO 视觉编码器,面向长程 Agent,统一文本、图像、文档页与视频理解,并支持工具调用与可开关推理。官方称 HF 同日放出 BF16 与 NVFP4 权重、训练数据与配方,许可 OpenMDW-1.1,可商用;上下文最长约 1M token,原生 Multi-Token Prediction(MTP)做推测解码。
官方线程与模型卡要点:BF16 参考部署约 4×H100 或 2×GB200;NVFP4 面向更省显存的推理。NVIDIA 称在 1 万道编码任务上可比对照配置快约 4 倍且保持较强 SWE-Bench Pro;Artificial Analysis 速度对比图显示长输入下吞吐有优势。LangChain 称其 Deep Agents 行为套件通过率约 87%。HF 仓库 id 为 nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16(及 NVFP4 变体),发布当日已有下载。此前仓库与文档已出现该型号,但今日才是官方 GA 与权重落地。
谁能用:开放权重——Hugging Face 免费下载(OpenMDW-1.1,可商用/非商用),可用 vLLM / SGLang 自托管,无申请门槛,但 BF16 级推理需多卡数据中心 GPU,不适合消费级单卡。托管侧:OpenRouter 已上线 nvidia/nemotron-3.5-super-vl:free(官方目录标价 $0/$0);NVIDIA NIM / build.nvidia.com、Together、Baseten 等亦宣布接入或微调支持,额度与排队以各平台为准。无单独的「App/Search」消费产品通道。
解读:这是 Nemotron 家族把「开权重 + Agent 配方」推进到 120B 级多模态的关键一步——文本与视觉不再拆两个模型来回传上下文,对文档智能、图表、视频 Agent 更友好;OpenRouter 免费档会加速试用,但真实落地仍卡在多卡成本与后训练配方复现。与此前传言中的 Nemotron 3.5 Bolt(本地 74B)不同,Super VL 是明确的数据中心/开放 Agent 路线。讨论:1. 对文档/视频 Agent,你会优先选统一 VL 大模型,还是「文本强模型 + 专用视觉」拼装?2. OpenMDW + 免费托管,会不会改变企业采购闭源多模态的默认路径?