整理:TopAIMap 编辑
Magnitude 开源本地推理引擎:在你的芯片上自动调优内核,11 个热门开源模型平均解码比 Ollama 快约 2.2 倍;Apache 2.0、免费
10 月 15 日约 6:03am(PT),YC S25 团队 Magnitude 联合创始人 @tomgreenwald 发布开源推理引擎 Magnitude:下载模型时在本机芯片上花最多约 1 分钟自动搜索最快的内核切分参数,并为每个模型内置最快的投机解码 drafter。官方基准(11 个热门本地模型、4-bit、64k 上下文、双方都开投机解码):Mac M4 Pro 48GB 上对 Ollama(MLX)解码快 2.19 倍、预填充快 1.32 倍;NVIDIA DGX Spark 上对 Ollama(llama.cpp)解码快 2.17 倍、预填充 1.34 倍。官宣帖约 3.8 万浏览、760 赞;GitHub 仓库约 6.8K star。
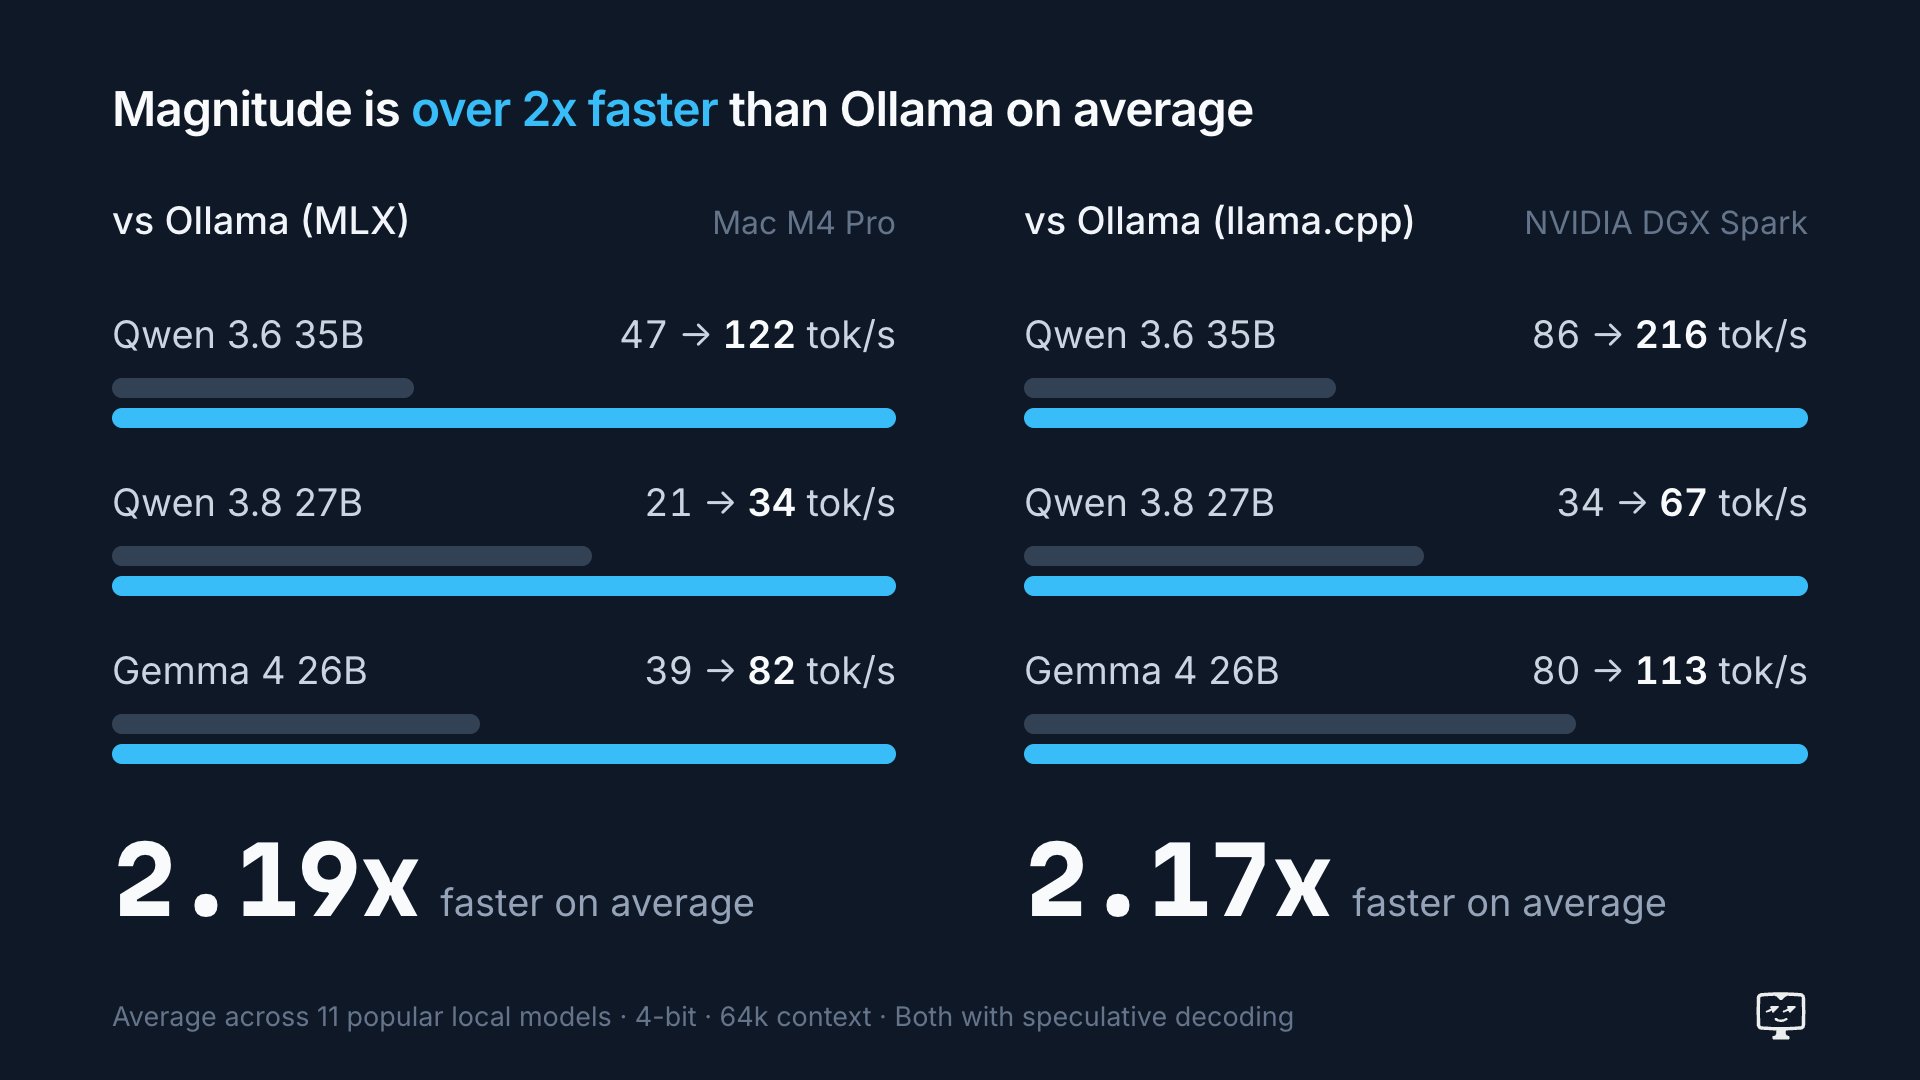
条件与细节:引擎用 Rust 编写,自带 GPU 内核运行时与 autotuner;KV cache 量化让每个 agent 会话内存约减半,并发会话共享前缀缓存避免互相拖慢。示例:Qwen 3.6 35B 在 Mac M4 Pro 上 47→122 tok/s、在 DGX Spark 上 86→216 tok/s;Gemma 4 26B 在 Mac 上 39→82 tok/s。官方也写明短板:Nemotron 3.5 在 DGX Spark 上解码、Gemma 4 E2B 在 Mac 上预填充等场景比 Ollama 慢,已计入平均;Mac 上 Ollama 对 Gemma 4 在 64k 时几乎没起草 token,这部分收益有「投机解码 vs 几乎无投机」的成分;M5 系 Mac 的预填充加速路径还在补丁中。基准脚手架开源,可自行复测。
真实用法:定位是「给你已在用的 coding agent 换一个更快的本地后端」——一键接入 Pi、OpenCode、Hermes、OpenClaw、Codex、Claude Code、Oh My Pi、Cline,其余工具走 OpenAI 兼容 API。典型场景是在 Mac Studio / MacBook Pro 或 DGX Spark 上跑 Qwen 3.6/3.8、Gemma 4 这类 4-bit 开源模型做长上下文(64k)agent 任务,多开 agent 时靠量化 KV 和前缀缓存省内存。
谁能用:完全免费、开源(Apache 2.0),以桌面应用形式提供,支持 macOS / Linux / Windows;硬件为 Apple Silicon、NVIDIA、AMD GPU 或纯 CPU,无固定最低配置(内存决定能跑多大模型)。无需账号、无 token 费用,模型下载后可离线运行、数据不出本机。仅支持官方做过优化内核的热门开源模型家族(列表见 magnitude.dev/models),不提供云端托管或付费版。项目地址:https://github.com/magnitudedev/magnitude (官网 magnitude.dev)
解读:本地推理的瓶颈正在从「能不能跑」转到「跑得够不够快给 agent 用」——Magnitude 押注的是「按芯片自动调优 + 每模型专配 drafter」,用专门化打败 Ollama / llama.cpp 这类通用引擎。讨论:1. 只为热门模型家族写内核,能否跟上每周都有新开源模型的节奏?2. 当 Muse Spark Open、Nemotron 3.5 这类大模型开始瞄准桌面,推理引擎会不会成为本地 AI 新的竞争主战场?