整理:TopAIMap 编辑
FrontiersMind 开源 Lumma-Fev-27B:27B 决策模型单次前向打分,自测 4454 题准确率 90.7% 超 Jev
基于 Qwen3.8-27B 全参数微调的决策模型,输入状态与选项后一次前向返回各选项概率,不生成文本;支持英/印地/泰米尔/卡纳达语,权重 Apache 2.0,约需 55GB 显存自托管。
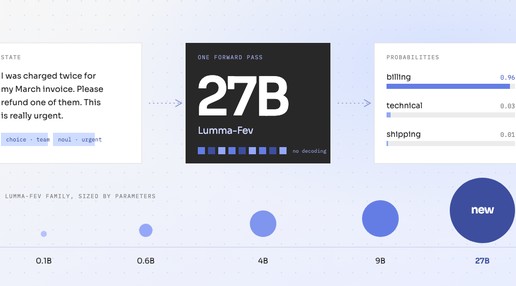
10 月 14 日,FrontiersMind 在 Hugging Face Blog 发布并开源 Lumma-Fev-27B。它是该公司 Lumma-Fev「决策模型」家族的最大规格:从 154M–9B 扩到 27B,底座为 Qwen3.8-27B,对约 10 万条决策样本做全权重微调(无 LoRA、无冻结层)。用法是给定一段 state(文本/JSON/数组)和若干 typed questions(choice / noul 等),模型在一次前向中为每个选项打分并返回概率与置信度,而不是生成一段再解析。官方在 4454 条 held-out 决策上报告准确率 90.7%,对照 TypeSafe Jev 为 83.9%,置信度校准更好;在 BBH、WinoGrande 等推理基准上 Jev 仍领先。
谁能用:权重 Apache 2.0,Hugging Face 仓库 FrontiersMind/Lumma-fev-27B 公开可下,无门禁。本地:pip install "lumma-fev>=0.2" 后 load("FrontiersMind/Lumma-fev-27B"),官方称约需 55GB 空闲显存(单卡约 80GB)或 device_map=auto 多卡;可加 flash-linear-attention / causal-conv1d 加速。自建 API:pip install "lumma-fev[serve]" 后 lumma-fev-serve --model 27b,提供与 TypeSafe 兼容的 POST /v1/systemone。无官方云端 Free/Pro 订阅说明,属自托管开源权重;单题+状态上限约 8192 tokens,可选装 images 扩展。
解读:决策模型把「选哪个动作/哪个团队」从生成式 agent 循环里拆成分类前向,官方宣称可比传统 agent 快两个数量级量级,和 NVIDIA 本周强调 decision models 进 llama.cpp 的方向一致。27B 全参微调门槛不低(显存与数据),但 Apache 权重降低了企业内嵌路由/分流的成本;需注意其自建基准对 Jev 的优势未必泛化到开放推理任务。 讨论:1. Agent 编排里,关键决策该交给决策模型还是继续用大模型 CoT?2. 自建 held-out 准确率公开时,业界该如何要求对照集与复现?