整理:TopAIMap 编辑
DeepSeek V4.1 Flash 入榜 AA-AgentPerf:GB300 达约 2.61 亿 tok/s/MW
Artificial Analysis 将 DeepSeek V4.1 Flash 加入智能体推理基准 AA-AgentPerf;在每用户 100 tok/s 设定下,NVIDIA GB300 系统吞吐约 261M tokens/s per MW,位列当面硬件榜首。
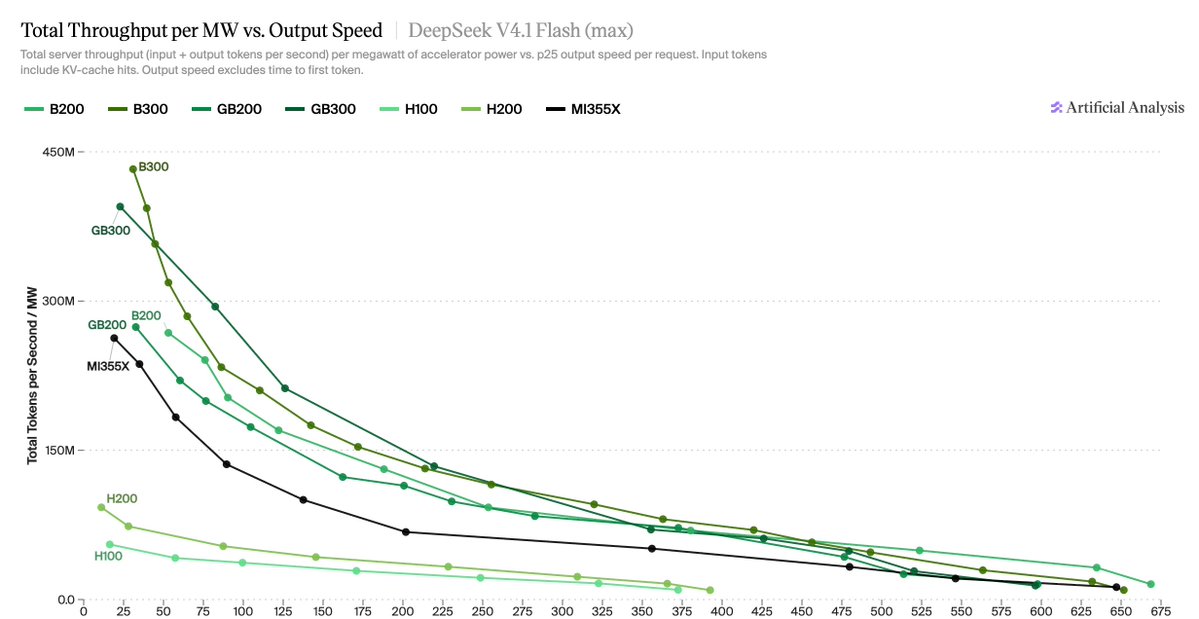
2026-10-14(约美西 12:04am PT),评测机构 Artificial Analysis(@ArtificialAnlys)宣布:已把开源权重模型 DeepSeek V4.1 Flash 加入 AA-AgentPerf,并公布 NVIDIA / AMD 硬件结果。该基准回放真实 agentic 编程会话(含 prompt caching 与工具调用延迟),同时报告单位兆瓦吞吐与不同并发下的单用户输出速度。在每用户 100 tok/s 目标下,GB300 约 261M tok/s/MW,其后为 B300≈220M、B200≈193M、GB200≈178M、MI355X≈128M;单 agent(batch=1)上 Blackwell 与 MI355X 约可达 600–670 tok/s。AA 称 V4.1 Flash 在 Intelligence Index 得分 39,高于同厂 V4 Pro 0813 的 36,却仅约三分之一参数规模(约 552B 骨干 / 16B 激活,对 1.6T / 49B);架构为因果 encoder-decoder(输入激活约 8B、输出约 16B),另含可放主机内存的 Engram n-gram 记忆与更省的稀疏注意力 KV。
谁能用:DeepSeek V4.1 Flash 为 MIT 开源权重,可自托管(Hugging Face:deepseek-ai/DeepSeek-V4.1-Flash);官方 API 模型名 deepseek-flash,高峰价约 $0.30/M 输入、$1.20/M 输出(缓存命中更低,非高峰约半价),亦经 OpenRouter 等多家 API 聚合可用;并非 ChatGPT/Claude/Gemini 的 Free/Pro/Ultra 订阅档位,也无 Antigravity 等 Google 产品面。AA-AgentPerf 榜单本身免费公开浏览;本条新闻节点是「入榜 + 硬件吞吐对比」,不是新模型首发(模型约 2026-09 发布)。 解读:开源 Flash 级模型被放进「真实 agent 会话」吞吐榜,比单卡 spew tok/s 更能回答「能不能 concurrent 养一队 coding agent」。讨论:① 在 100 tok/s/用户体验门槛下,GB300 相对 B300 的能效优势会不会继续拉开?② 自托管 2 卡起服 vs 官方 API 高峰价,团队更该盯哪个成本曲线?