整理:TopAIMap 编辑
Claude Code 本地会话首 token 等待降到 1.33 秒(约 3 倍);官方用 gzip 压缩每轮对话,云端会话与 Chat/API 同步提速
ClaudeDevs 于 10 月 16 日(约 2:34pm PT)官宣:Claude Code 每轮发送前对会话做 gzip,本地首 token 等待(p90、不含模型时间)从 4.07s 降至 1.33s(约 3×);云端会话 16.99s→6.00s(约 2.8×);Chat/Cowork 与 API 约 1.5×。非新模型,是传输与会话启动优化。
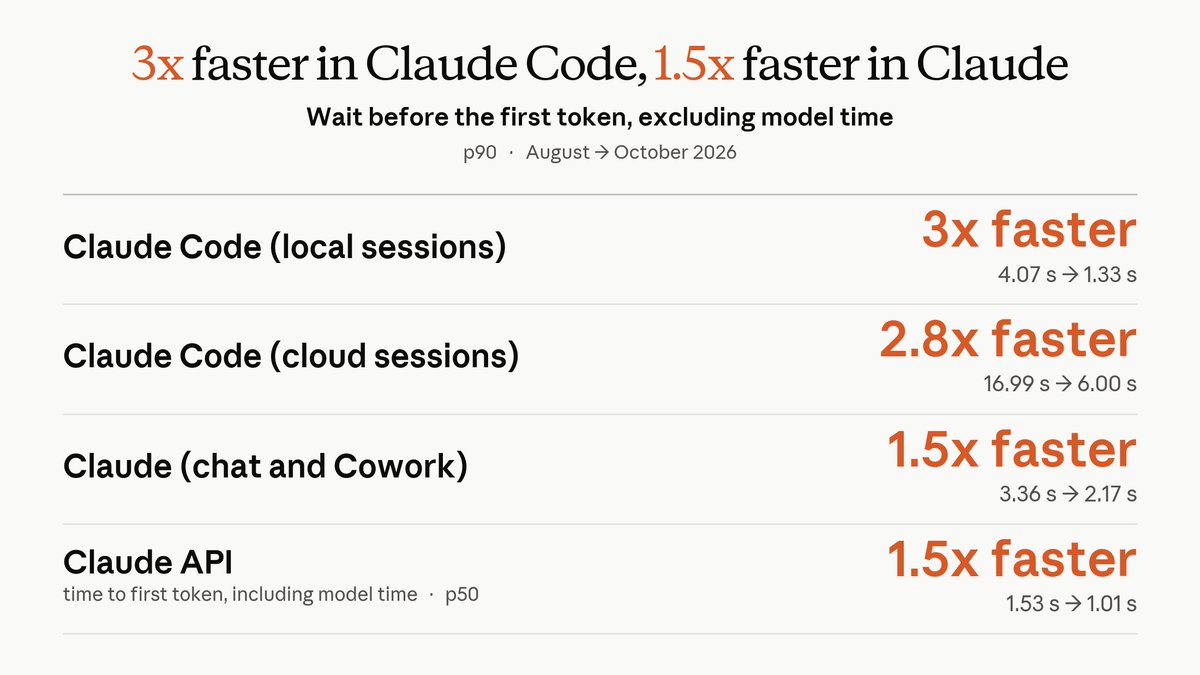
Anthropic 官方开发者账号 ClaudeDevs 于 2026 年 10 月 16 日约 14:34 PT 发帖称,Claude 全线「开始回复」前的等待在缩短:Claude Code 现在每轮把发给模型的会话做 gzip 压缩以加快到达;云端会话在用户开始打字时即启动。配图给出 8→10 月 p90「首 token 前等待、不含模型时间」:Claude Code 本地 4.07s→1.33s(约 3×),云端会话 16.99s→6.00s(约 2.8×);Claude 聊天与 Cowork 3.36s→2.17s(约 1.5×);Claude API 在含模型时间的 p50 首 token 上为 1.53s→1.01s(约 1.5×)。帖文互动约 5.6k 赞、22 万+ 曝光(以抓取时为准)。这不是新权重或新模型档,而是传输与会话预热。
谁能用:本地 Claude Code 用户(含 Free/Pro/Max 个人以及 Team/Enterprise 里跑 Claude Code 的开发者)自动吃到 gzip 与本地延迟改善,无需改模型选择器。云端 Claude Code 会话受益于「开始输入即启动」。Claude App 聊天与 Cowork 用户约 1.5×;Claude Platform API 客户在 TTFT(含模型时间、p50)上约 1.5×。不涉及新的 Pro/Ultra 档位、临时价或候补名单;费用仍按原有方案与 token/额度计,压缩本身不改变计费内容等价性。注意:这与同日前后热传的「Code Review GA 审查时长约 3×」是另一条产品线——后者是 PR 审查从约 20 分钟到 6–10 分钟,本条是对话首 token 等待。
真实用法:长会话、多文件 diff、反复失败尝试的 Claude Code 用户最先有感——每轮往返体量变大时,gzip 主要砍的是「模型还没开始算」的传输等待;开发者反馈称胖会话仍会拖累,建议清掉过期 diff/失败尝试。云端侧「边打字边预热」适合远程会话冷启动。日常 Chat/Cowork 提速约 1.5×,更适合高频短问。API 集成方可对照自家 p50 TTFT 看是否落在约 1s 量级。社区也有人澄清:gzip 只缩 request body,服务端解压后内容等价,不改变模型质量。
解读:在不换模型的前提下用 1990 年代压缩算法换来可感知的交互速度,说明当前瓶颈常在「上下文怎么搬」而非「再大一个权重」。对订阅用户是无感利好;对评测榜单几乎无分——分数不变、体感变快。讨论:1. 你更在意首 token 等待,还是生成吞吐?2. 若胖会话仍慢,你会用压缩/预热,还是强制开新会话清上下文?
参考资料