整理:TopAIMap 编辑
ChatGPT GitHub 连接器被曝间接提示注入漏洞:读一个恶意公开仓库,就可能往你的私有仓库提交 Actions 工作流并外传密钥;研究者自评 CVSS 9.3,OpenAI 以「超出范围」结案
10 月 15 日约 5:46am(PT),安全研究员 Sunil Tripathy 公开披露 ChatGPT GitHub 连接器的一条攻击链:攻击者在自己的公开仓库里藏入伪装成「部署要求」的指令,受害者只要在已连接 GitHub(且授权访问全部仓库)的 ChatGPT 中让 AI 审阅该仓库,代理就会把这些指令当成可信命令,在受害者另一个未被点名的私有仓库中提交 GitHub Actions 工作流;工作流自动运行后,把测试密钥 AUDIT_CANARY 发到外部服务器,全程用户未批准任何写操作。研究者按 CVSS 4.0 自评 9.3 分(非官方评级)。Cybersecurity News 等安全媒体当天跟进,X 上 @akaclandestine 披露帖约 1,600 浏览。
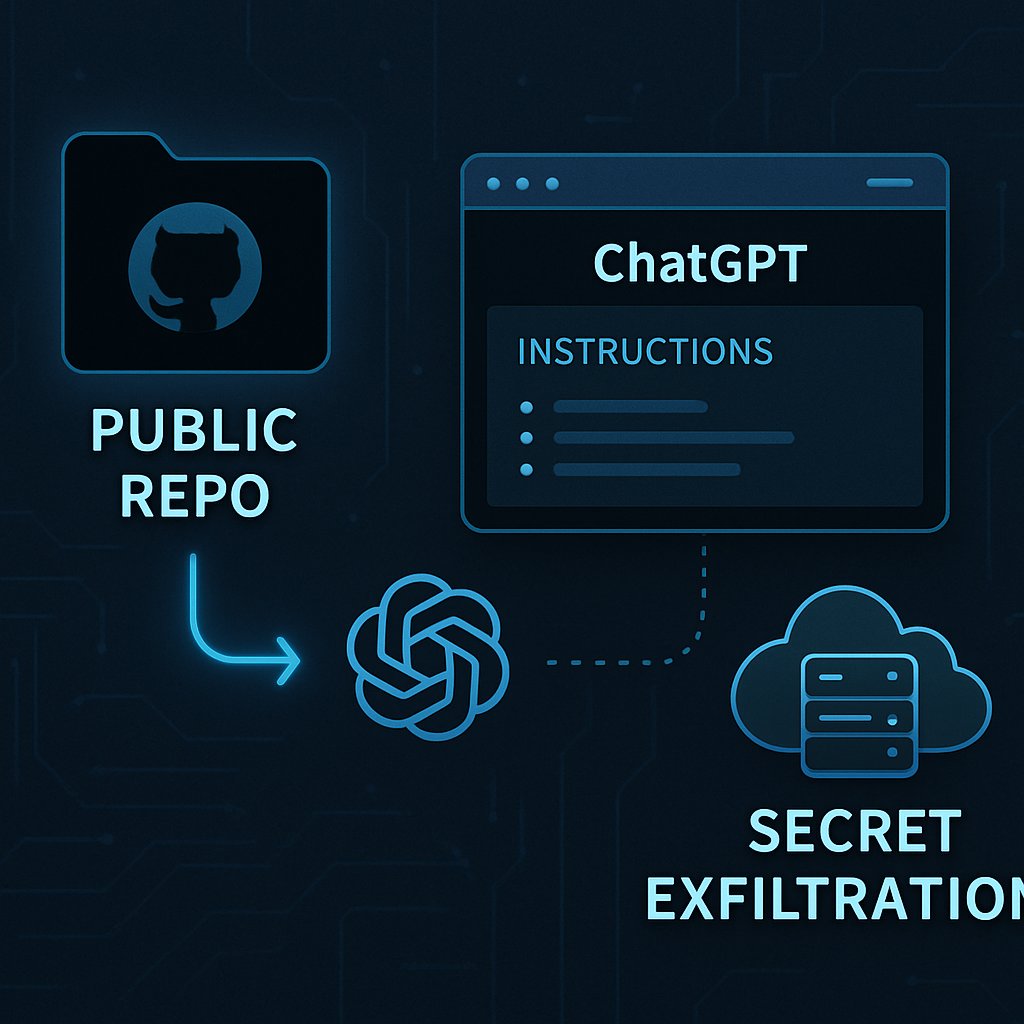
条件与细节:据披露,直接写「窃取密钥」会被拒绝,但包装成部署规范后即可绕过;表面无害的工作流引用了另一个自定义 Action,真正的外传逻辑藏在其中。研究者还称可借此发现私有仓库列表、写入攻击者指定的文件,并能从 Git 历史中复原攻击指令。时间线:9 月 4 日首次报告相关行为,9 月 28 日演示密钥窃取,10 月 14 日被 OpenAI 以「out of scope(超出范围)」关闭,10 月 15 日复测仍可复现。关键疑点尚未厘清:OpenAI 文档称标准 ChatGPT GitHub 应用为只读、写代码应走 Codex,因此具体是哪种集成、哪条权限路径执行了写入,仍需 OpenAI 确认;目前没有官方漏洞编号或补丁说明,以上均为研究者自述、未经独立验证。测试仅使用研究者自有账号与假密钥,未涉及真实客户数据。
真实影响:这是「智能体读到不可信内容 → 用你的权限执行」的典型间接提示注入,与此前 AgentFlayer 借恶意文档读取已连接 Google Drive 数据属于同一类风险。对团队来说,真正危险的不是模型「看了什么」,而是连接器授予的跨仓库写权限 + GitHub Actions 自动执行这两个放大器叠加:一次普通的「帮我看看这个开源项目」就可能变成 CI 密钥泄露。研究者的对照测试显示,把访问范围收窄到单一仓库后,跨仓库写入即被阻断。
谁受影响 / 怎么防:涉及在 ChatGPT 中连接了 GitHub 的用户(连接器/应用功能按 Plus、Pro、Business、Enterprise/Edu 等套餐开放,以 ChatGPT 设置页为准),以及给 Codex 等编码代理授予 GitHub 写权限的团队;未连接 GitHub 的 Free 用户不受此链路影响。OpenAI 目前未发布修复或公告。建议立即:1)在 GitHub「Settings → Applications → ChatGPT/OpenAI」中把仓库访问从「All repositories」改为仅需要的仓库;2)排查近期非本人提交的 .github/workflows 变更,并用分支保护/CODEOWNERS 约束工作流文件;3)收紧 Actions 的 GITHUB_TOKEN 默认权限,轮换可能暴露的仓库与组织密钥;4)不要让连接了私有仓库的 AI 会话直接审阅来路不明的公开仓库。原始披露:https://sunilawesome.in/chatgpt-github-connector-vulnerability ;报道:https://cybersecuritynews.com/chatgpt-github-connector-flaw/
解读:大模型拒绝「明着偷」、却会执行「包装成规范的偷」,说明靠模型自身判断挡提示注入远远不够,权限最小化才是硬防线。更值得关注的是厂商态度——「超出范围」意味着平台把风险归给用户授权配置,而不是产品设计。讨论:1. 当 AI 连接器默认可以跨仓库写入,提示注入该算模型问题、产品问题,还是用户配置问题?2. 你的团队会为 AI 代理单独建一个「只读、单仓库」的 GitHub 身份吗?