整理:TopAIMap 编辑
ARC Prize 验证 Gemini 4 Argon:ARC-AGI-3 达 97.5%(约 $4.8K),Google 成第二家破 95% 的前沿实验室;标准 harness 仅 49.8%
10 月 15 日 9:22am(PT),ARC Prize 基金会官方账号 @arcprize 公布 Gemini 4 Argon 的 ARC-AGI Verified 成绩:ARC-AGI-3 在「供应商适配器」(provider adapter)harness 下 97.5%(成本约 $4.8K),在统一的标准 harness 下 49.8%(约 $5.8K);ARC-AGI-2 91.3%(每题 $0.32),ARC-AGI-1 98.5%(每题 $0.16)。Google DeepMind 由此成为继 OpenAI 之后第二家在 ARC-AGI-3 上超过 95% 的前沿实验室,仅次于 GPT-6 Astra 的 99.9%。官方帖约 7.2 万浏览、828 赞。
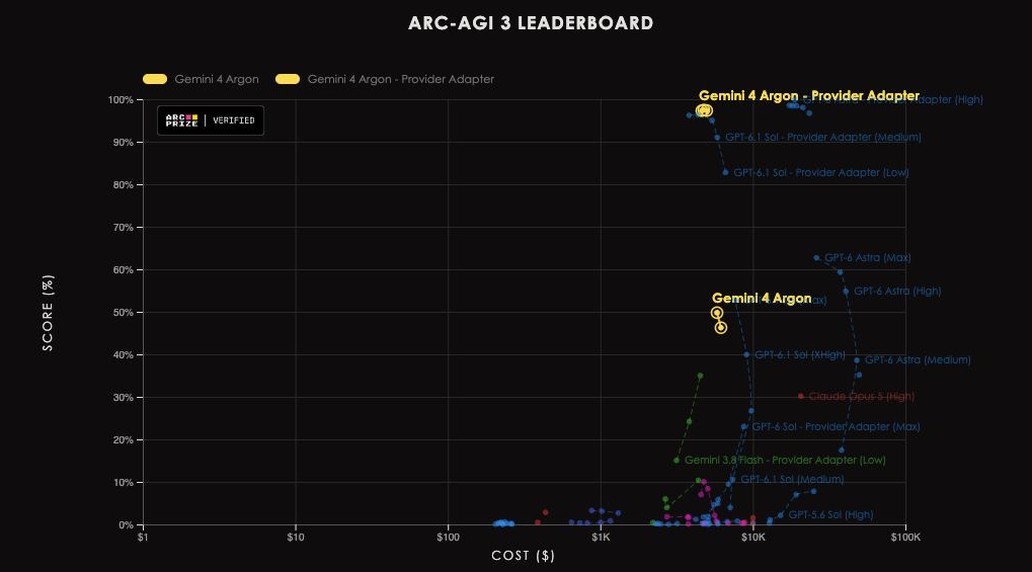
条件与细节:两种 harness 的差距是这条新闻的关键——97.5% 来自 Google 自己提交的 provider adapter(按自家模型的接口与工具调用习惯定制交互层),换成 ARC Prize 统一的标准 harness 只剩 49.8%,成本反而更高。ARC-AGI-3 是 25 个公开交互式游戏,考察模型在陌生环境里边玩边学;ARC Prize 补充称,Argon 与 Astra 一样,所用动作数比人类基线少 62%,在 3 个游戏上追平或打破速通纪录,另有 6 个差距在 10% 以内。排行榜图上,GPT-6.1 Sol 的 provider adapter 档位也在 80%–90% 以上,标准 harness 下各家普遍低得多。影响:ARC-AGI-1/2 已近见顶,ARC-AGI-3 在适配器条件下也接近饱和,评论区已开始催 ARC-AGI-4。
真实用法:开发者盯的是「每题成本」——ARC-AGI-2 每题 $0.32、ARC-AGI-1 每题 $0.16,意味着这类抽象推理任务已便宜到可以批量跑;但也有用户提醒「按 token 便宜不等于按任务便宜」,早期使用者反映 Argon 的 token 消耗偏高。团队侧的实际用法仍集中在 Gemini API 跑 agent 评测与规划、GitLab Duo 和 Antigravity 里做编码/规划模型;这次 ARC 数据更直接的用途,是给选型的人一个「适配器做得好,交互式任务能差一倍」的参照。
谁能用:Gemini 4 Argon 已于 10 月 13 日 GA。Gemini App 与 Google 搜索 AI 功能需 Google AI Pro 或 Ultra;Antigravity 编码环境目前仅 Ultra 与 Enterprise(Pro 不可用);付费 API 全球开放(模型名 gemini-4-argon),入门价约输入 $2 / 输出 $10(每百万 token),约 11 月 30 日后调整为 $4 / $20,另有排队与容量限制;Free 档用不到 Argon。注意:97.5% 用的是 Google 提交的定制 harness,普通 API 用户直接调用不会自动获得同等表现。
解读:Argon 在 ARC-AGI-3 上追到 Astra 身后,说明「交互式推理」已不再是某一家独有;但 97.5% 与 49.8% 的落差同样说明,今天的成绩一半在模型、一半在 harness——谁能把模型接进环境,谁就拿高分。对 benchmark 来说,provider adapter 成绩该不该和标准 harness 同榜排名,会越来越有争议。讨论:1. 你更看重厂商自定 harness 的上限分,还是统一 harness 的下限分?2. ARC-AGI-3 接近饱和后,下一代 benchmark 应该考什么,才不会被 harness 工程「刷」掉?