AA Coding Agent Index v2.0:Claude Opus 5.5 登顶 61.7,DeepSeek 性价比领跑
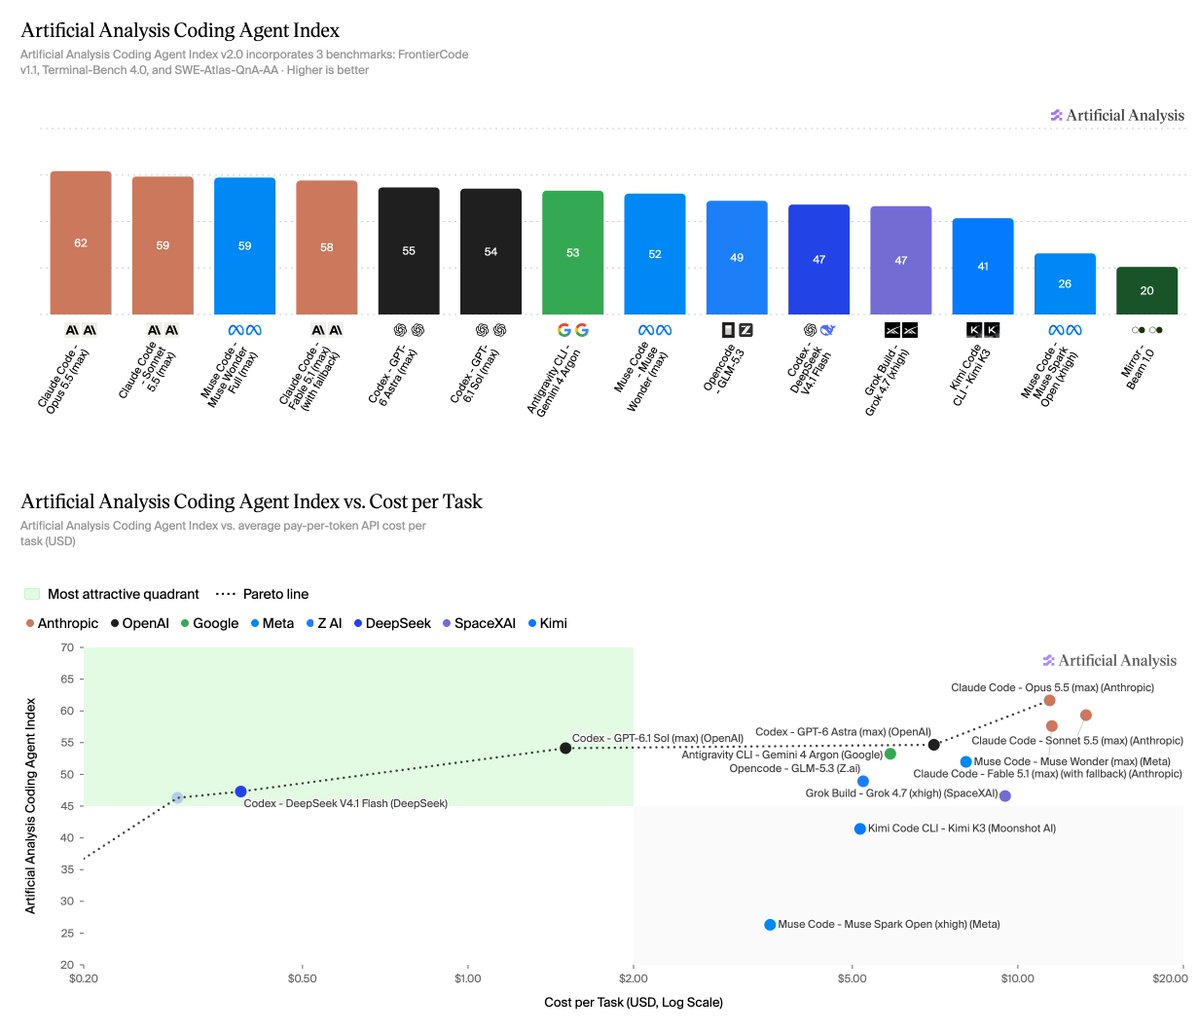
Artificial Analysis 10 月 23 日推出 Coding Agent Index v2.0:用 Cognition FrontierCode v1.1 替换 DeepSWE,并收紧仓库问答评分。Claude Code + Opus 5.5(max)以 61.7 居首;Codex + DeepSeek V4.1 Flash 约 $0.39/题、分 47.3,站在成本前沿。
指数等权合成三块共 290 题:FrontierCode v1.1(100 道真实开源仓改动,按「维护者愿不愿 merge」打分)、Terminal-Bench 4.0(66)与 SWE-Atlas-QnA-AA(124)。相对 v1.5,DeepSWE 被 FrontierCode 顶替;QnA 有 127 条量规改写,裁判换成 GPT-6 Luna(xhigh)五票。
官方关键数字(max):Claude Code + Opus 5.5 61.7(约 $11.42/题),Sonnet 5.5 59.3,Muse Code + Muse Wonder Full 58.9,Fable 5.1 57.6。FrontierCode 上 Opus 56.0% 领先 Codex+DeepSeek Flash 的 52.6%。成本前沿四档:DeepSeek Flash $0.39 / GPT-6.1 Sol $1.50 / Astra $7.04 / Opus $11.42(均为按 token API,非订阅价)。