整理:TopAIMap 编辑
AA-3D 离线造埃菲尔铁塔:Claude Opus 5.5 与 Grok 4.7 凭记忆刻出全部 72 位科学家姓名
Artificial Analysis 的 AA-3D 测试只给约 200 词外形需求、从未提塔身刻名,Claude Opus 5.5 与 Grok 4.7 却离线写出全部 72 个名字且顺序正确,是唯二做到的模型。
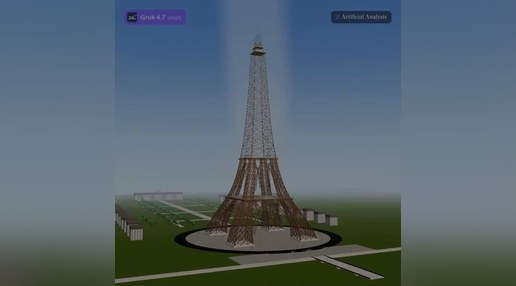
10 月 14 日晚(PT),独立评测机构 Artificial Analysis 公布 AA-3D 的一项离线测试:每个参测模型拿到同一份约 200 词的需求,只描述埃菲尔铁塔的外形、桁架、平台和灯光,完全没提塔身刻名。结果 Claude Opus 5.5 和 Grok 4.7 在生成的 3D 场景里,自己写上了第一层平台下方刻着的全部 72 位法国科学家、工程师与数学家的姓名,顺序正确。据转述,名字按每面 18 个排布,Claude 还把每组放在了现实中朝向对应的那一面。AA 表示「没有预料到」,这条推文约 210 赞、1.5 万次曝光。两款是唯二这样做的模型。
谁能用:AA-3D 是 Artificial Analysis 公开的评测与演示,在官网和 X 上都能看;被测的是已经上线的 Claude Opus 5.5(Anthropic)和 Grok 4.7(xAI),这次不是新模型发布,具体可用档位以两家官方为准。同周 AA 还发布了 AA-Robotics v0.1,GPT-6 Astra 以 69 分居首,Opus 5.5 得 49 分。影响:做 3D 和前端代码生成时,模型会主动把训练中记住的事实写进产物,细节还原度明显更高。
解读:这件事更像「知识召回 + 自主补全」的展示,而不是 3D 能力的胜负。对用户来说,模型主动加上需求里没写的真实细节,在复刻、教育、文旅这类场景是惊喜;但到了要求严格按规格交付的场景,就是不可控的「自作主张」。另外,评测打分若只看外形相似度,就区分不出事实召回的差异,AA 后续是否把两者拆开计分值得关注。 讨论:1. 你希望模型主动补全需求里没写的真实细节,还是严格按 brief 交付?2. 这种「惊喜型」能力该不该进正式榜单的计分?
来源:Artificial Analysis(X)https://x.com/ArtificialAnlys/status/2110570099602280475